Вкладка Network в інструментах розробника Chrome показує все, що браузер отримує від Google чи ChatGPT. Звідти SEO-фахівець може побачити, які дані Google довантажує у видачу, за якими запитами шукає ChatGPT, які сайти він прочитав і кого процитував. Mark Williams-Cook так знайшов вразливість у Google, за яку отримав $13,337. Я так знаходила дані з Графу знань Google (їх вже теж прикрили). Окремо ми протестували декілька запитів у ChatGPT 18 жовтня 2026 року спеціально для SEO Baza.
TLDR
- F12, вкладка Network, галочка Keep log, фільтр Fetch/XHR, запит.
- У ChatGPT дивись потік відповіді: там пошукові запити, прочитані й процитовані сайти.
- У Google дивись запити, які довантажують блоки видачі: копіюй як cURL і міняй параметри.
- Зберігай через Export HAR, а потік ChatGPT через розширення.
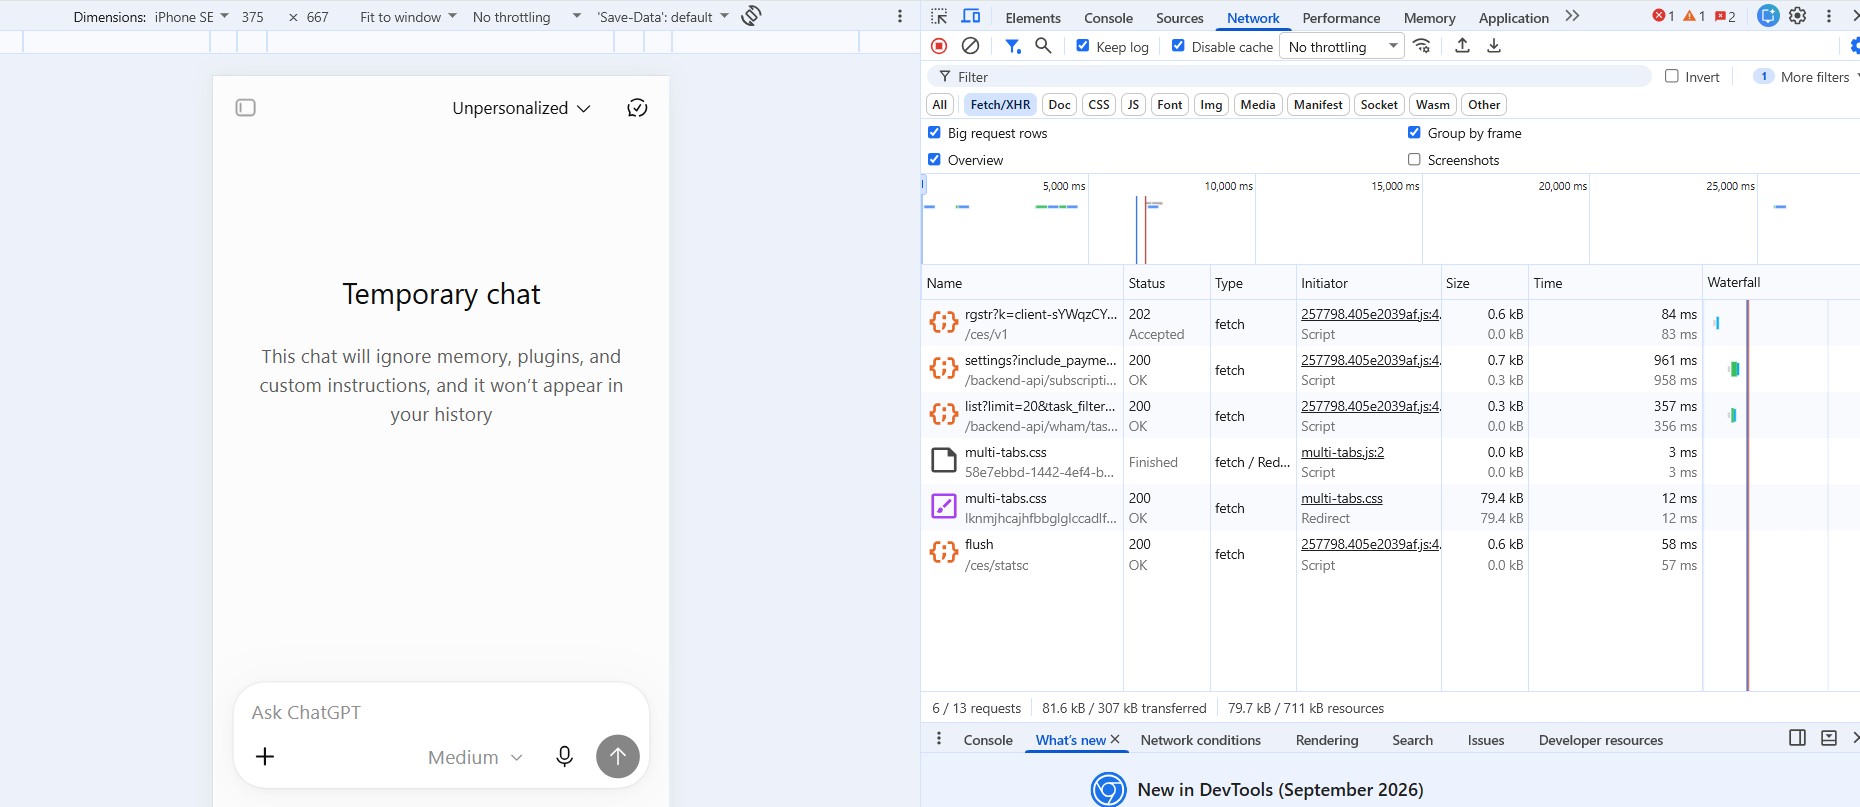
Крок 1. Відкрий вкладку Network
- Відкрий Google або ChatGPT у Chrome і натисни F12.
- Перейди на вкладку Network і постав галочку Keep log, у старіших версіях Chrome вона називається Preserve log. Без неї записи зникають при переході на іншу сторінку.
- Вибери фільтр Fetch/XHR, він ховає картинки, стилі та скрипти.
- Постав запит у Google або питання в ChatGPT і клацни на рядок у списку.
У кожного рядка є вкладки Headers (адреса і службові дані), Payload (що відправив браузер), EventStream (дані, які приходять потоком, поки ChatGPT пише відповідь), Response і Preview (що повернув сервер). Значок лупи шукає слово одразу в усіх відповідях, наприклад назву твого домену.
Крок 2. Google: знайди запити, які довантажують видачу
Видача Google збирається з багатьох окремих сервісів, які передають один одному оцінки й сигнали, це видно на схемі систем ранжування Mario Fischer. Після першого показу сторінка довантажує частину блоків окремими запитами, і саме в них трапляються дані, які Google не планував показувати.
- Після того як видача завантажилась, прокрути її вниз і розгорни блоки, які підвантажуються: People Also Ask, додаткові результати.
- У списку Network з'являться нові рядки. Відкрий у них Headers і подивись на адресу: довгий рядок параметрів після знака питання.
- Правою кнопкою на рядку, Copy, Copy as cURL. Встав у термінал і виконай.
- Прибирай параметри по одному або міняй їхні значення і порівнюй, що змінилось у відповіді.
Mark так знайшов у запиті People Also Ask параметр _fmt зі значенням prog. Без нього Google віддав оцінку якості сайту, оцінки рідкісності слів, дату останнього суттєвого оновлення сторінки, IP сервера і клас запиту rq_semantic_class. Цю вразливість Google закрив.
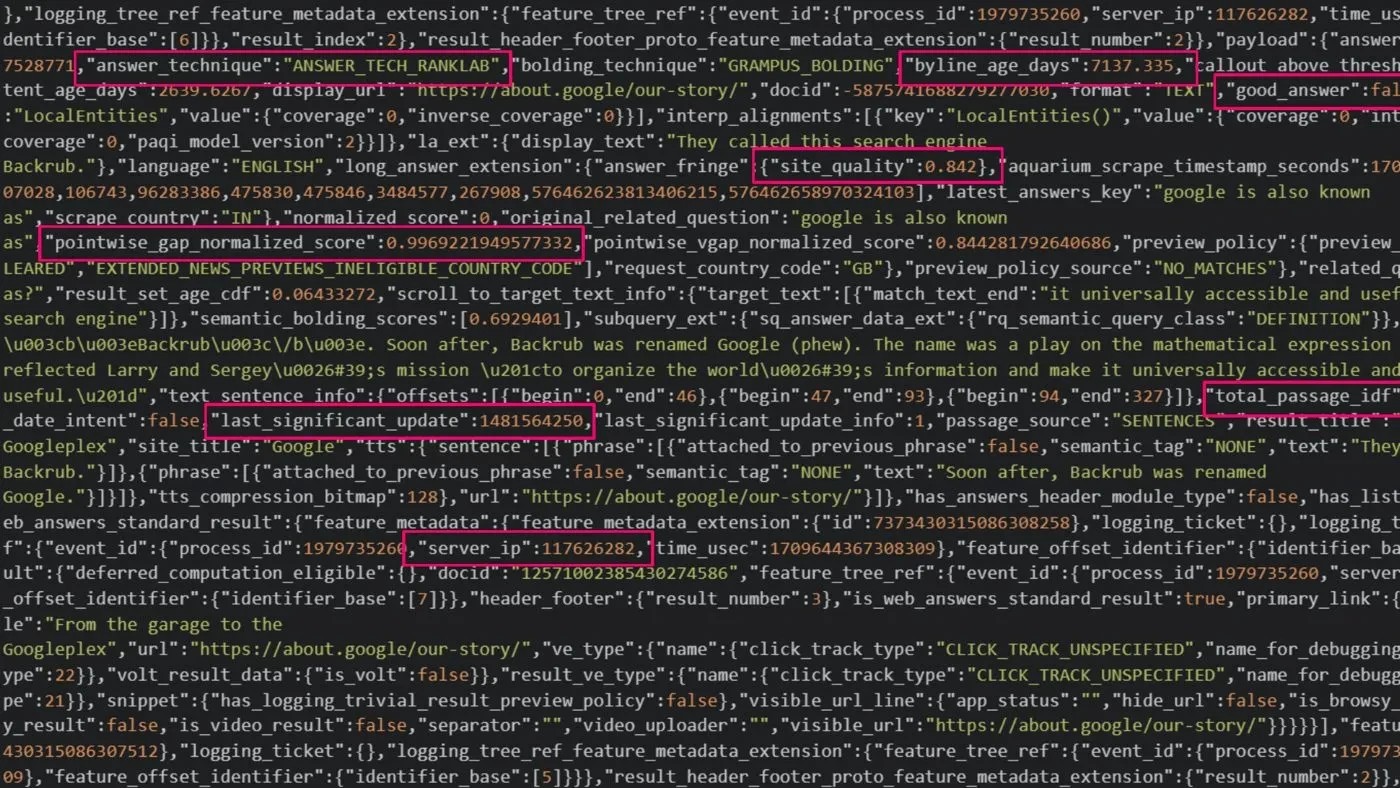
Клас запиту Google має 8 значень: так/ні, інструкція, короткий факт, визначення, порівняння, причина, наслідок, інше. Він пов'язаний з тим, які блоки Google покаже у видачі. Mark дотренував на 4,8 млн таких запитів модель і виклав безкоштовний QueryClassifier. Для українських ключів він не підходить: усі 8 наших українських запитів інструмент відніс до класу інше, тоді як англійські відповідники 7 разів із 8 потрапили у правильний клас.
Крок 3. ChatGPT: знайди пошукові запити
Для однієї відповіді ChatGPT у списку Network важливі чотири рядки. f/conversation/prepare і conversation/init службові. f/conversation з методом POST містить саму відповідь, яка приходить потоком. conversation/<id> з методом GET містить збережену копію розмови, вона з'являється, коли відповідь дописана.
- Клацни на
f/conversationз методом POST. - Відкрий вкладку EventStream.
- Знайди подію з полем
search_model_queries. У ньому список пошукових запитів, які ChatGPT сам склав з твого питання (їх ще називають фан-аутом).
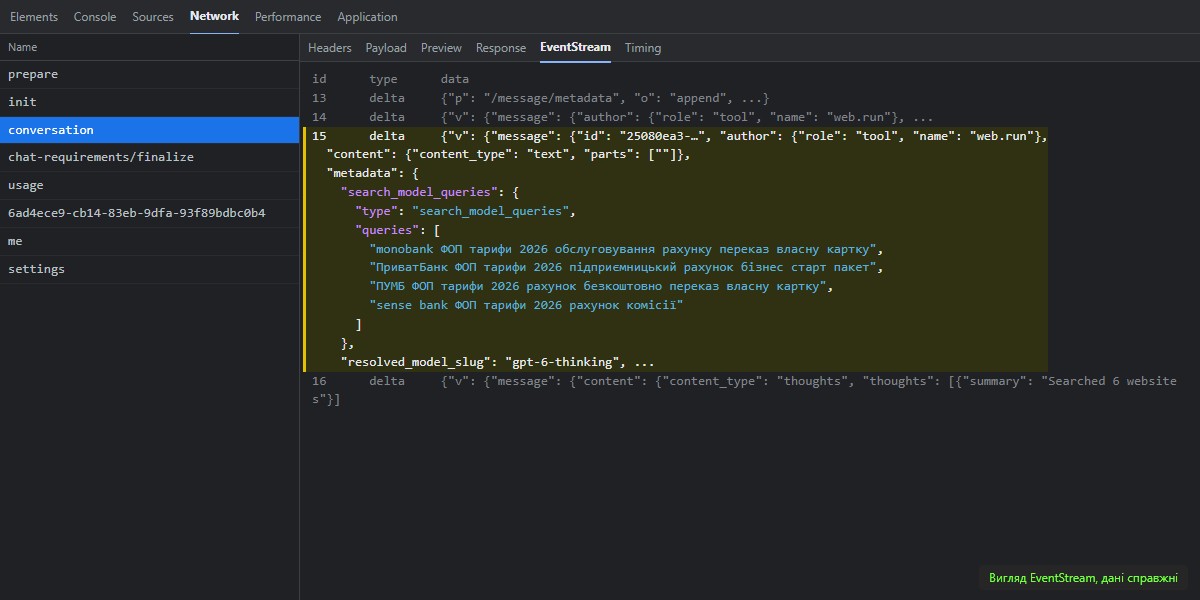
На одне питання ChatGPT робить від 2 до 4 запитів, і вони рідко збігаються з питанням. На питання українською, чому просів трафік з початку жовтня, він шукав англійською про Google Search Status Dashboard і оновлення ранжування за жовтень 2026 року. На питання про банк для ФОП усі чотири запити вже містили назви банків: monobank, ПриватБанк, ПУМБ, Sense Bank. У вузьких питаннях він шукає з оператором site: на конкретних сайтах, наприклад site:clutch.co/ua/seo-firms для SEO-підрядника або dou.ua і work.ua для зарплат.
Що ці дані показали на 25 наших розмовах, зібрано окремо в статті як працює пошук ChatGPT. Мову запиту ChatGPT обирає за темою і локацією. На питання про зимові шини з британської IP-адреси він шукав англійською з префіксом UK, з української IP-адреси українською. На питання про SEO, robots.txt і біткойн шукав англійською навіть з України.
Крок 4. ChatGPT: порівняй прочитане з процитованим
- Клацни на
conversation/<id>з методом GET. - Відкрий Preview, розгорни
mapping, знайди повідомлення асистента і розгорни йогоmetadata. - У
search_result_groupsусі сторінки, які ChatGPT отримав з пошуку: домен, заголовок, сніпет, дата публікації, тип джерелаref_type(звичайний пошук, Reddit, новини, місця, повністю відкрита сторінка). - У
content→partsзнаходиться текст відповіді. Посилання в ньому позначені тегами<Cite ref="turn508120search1"/>: номер ходу, тип джерела і номер результату. Той самий набір є в кожного результату вsearch_result_groupsу поліref_id. - Порівняй: скільки доменів у
search_result_groupsі на скільки з них є тег Cite.
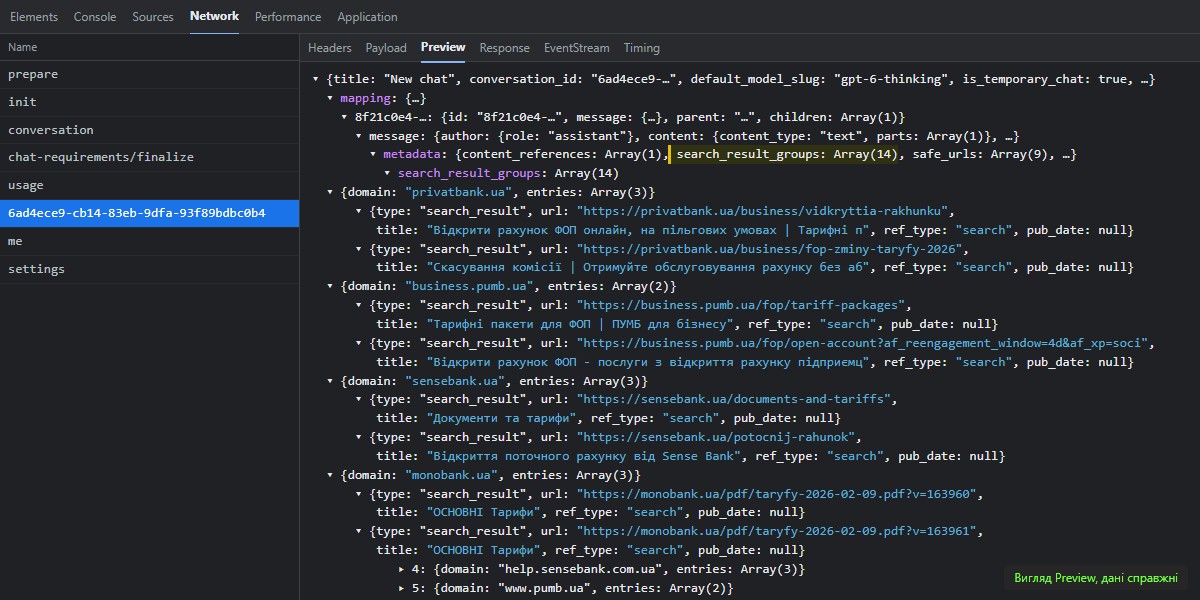
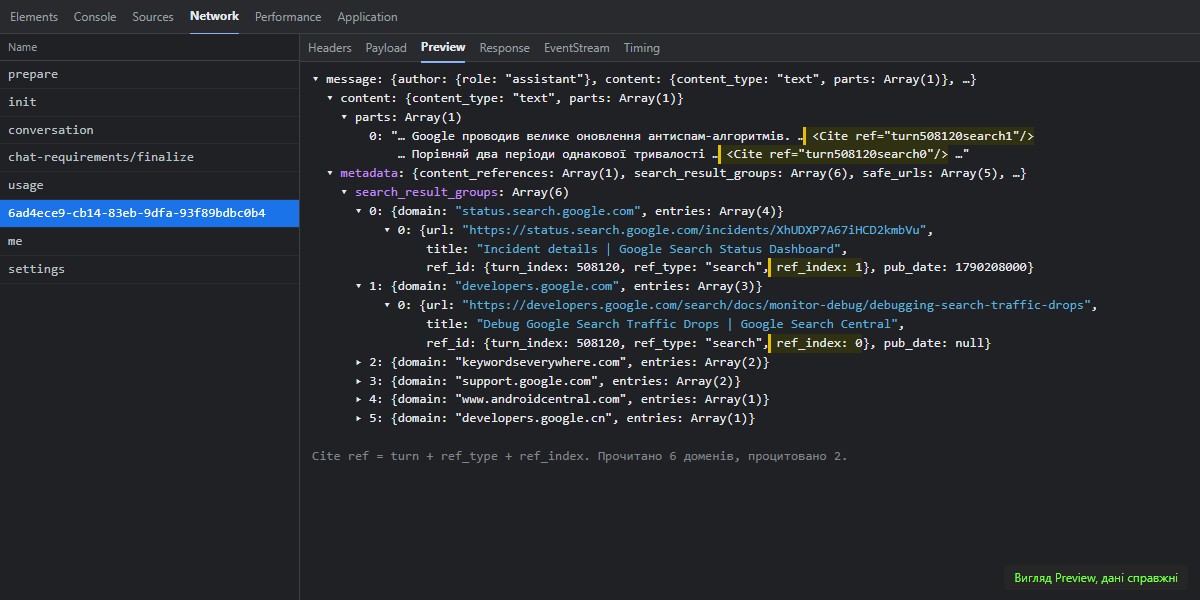
На питання, де українською читати новини SEO, ChatGPT прочитав головну seobaza.com.ua і розділ новин, а порадив Netpeak, Collaborator, Serpstat і Referr. На питання, кого з українських SEO-фахівців читати, він процитував нашу статтю 2022 року з переліком телеграм-каналів як галузеву добірку. За даними Suganthan Mohanadasan, після серпневого оновлення ChatGPT посилається на Reddit значно рідше, але читає його так само часто.
Крок 5. ChatGPT: перевір, чи був пошук узагалі
Коли ChatGPT шукав, у копії розмови є повідомлення з recipient: web.run і підсумок на зразок Searched 6 websites. Якщо їх немає, ChatGPT відповів з пам'яті моделі. Mark помітив, що на прохання порадити книгу з саморозвитку ChatGPT нічого не шукає. Усі питання, які ставили ми, ChatGPT відправив у пошук.
Suganthan бачив влітку після кожного пошукового запиту число, яке трактує як кількість днів, за які ChatGPT шукає матеріали: 2 для ціни акцій, 7 для футбольних результатів, 30 для комерційних запитів, 365 для Reddit. У наших розмовах у жовтні 2026 року цього числа вже не було. Так само зникло поле search_queries, яким користувався Mark. Тому шукай у потоці список рядків, схожих на пошукові запити, під будь-якою назвою поля.
Крок 6. Збережи дані
Кнопка ⤓ (Export HAR) у вкладці Network зберігає всі запити у файл. Копія розмови conversation/<id> у HAR є, а потік f/conversation Chrome зберігає порожнім, тому пошукових запитів ChatGPT у файлі не буде.
Щоб збирати і потік, ми зробили маленьке розширення Chrome, яке зберігає потік і копію розмови кожної відповіді у файли в папці Downloads. Розширення без Chrome Web Store ставиться через chrome://extensions: увімкни Developer mode, натисни Load unpacked і вибери папку з розширенням. Без коду те саме показує безкоштовне розширення FanoutFox: пошукові запити ChatGPT, отримані джерела і хто потрапив у посилання.
Став питання з одного акаунта і на одній моделі, бо від цього залежать результати, і враховуй локацію. Ми ставили питання в тимчасових чатах, щоб не підмішувалася пам'ять акаунта.
Як міряти частку свого контенту у відповідях Google AI через офіційний API, ми розбирали в гайді Share of AI Answer.