SynthID це водяний знак Google DeepMind у згенерованому контенті. На зображенні він живе в пікселях, зсунутих на один крок кольору, і його можна побачити на чорному квадраті. Зняти знак з картинки вдається лише перегенерацією з нуля іншою моделлю, і то не завжди. З тексту знак не знімає ні синонімізація, ні переклад, ні дописування. Нижче експерименти Данила Макарова з піпеткою й ComfyUI, наші спроби на обкладинці цього стріму і те, що з цього випливає для сайтів. Це текстова версія стріму про SynthID для SEOшників, відео можна дивитись паралельно:
Що таке SynthID і де він стоїть
SynthID мітить зображення, аудіо, відео і текст. Для картинок знак сидить у самих пікселях, для тексту в тому, який токен, тобто шматок слова, модель вибирає на розвилках, де кілька варіантів однаково ймовірні. Прочитати знак може лише той, у кого є ключ, тобто Google. Для картинок, відео й аудіо публічний детектор є: у травні 2025 Google показали портал SynthID Detector для журналістів і дослідників, а 7 жовтня 2026 відкрили synthid.com для всіх. Він бачить лише медіа від Google і партнерів: OpenAI, NVIDIA і Kakao, незабаром Apple. На самому сайті попереджають, що це не загальний детектор AI. За даними Google, з 2023 року помічено понад 180 мільярдів зображень і відео та 240 тисяч років аудіо. Для тексту публічного детектора немає. Текст Gemini несе знак з 2024 року, Claude з серпня 2026, як ми розбирали в статті про вотермарки в текстах Claude, а з 5 жовтня свій текстовий знак запускають і OpenAI. Детектори Anthropic і OpenAI теж у закритому доступі.
Офіційна причина знаків це стаття 50 європейського AI Act. Побічна користь для самих розробників прозаїчніша: помічений контент не потрапляє в тренувальні дані, і модель не деградує на власних генераціях. Є й зворотний рух: частина художників і авторів навмисно проганяє свої роботи через SynthID, щоб моделі вважали їх згенерованими і не брали в тренування.
Як побачити знак на зображенні: чорний квадрат
Оку знак невидимий, тому Данило взяв найпростіший можливий об'єкт: ідеально чорний квадрат з графічного редактора, RGB 0,0,0. Він прикріпив цей квадрат у ChatGPT Image і попросив його регенерувати, а потім поклав результат поруч з оригіналом. Gemini таких квадратів більше не генерує, бо так люди досліджують його знак, ChatGPT поки генерує. Перевірка у верифікаторі OpenAI підтвердила: картинка створена OpenAI.
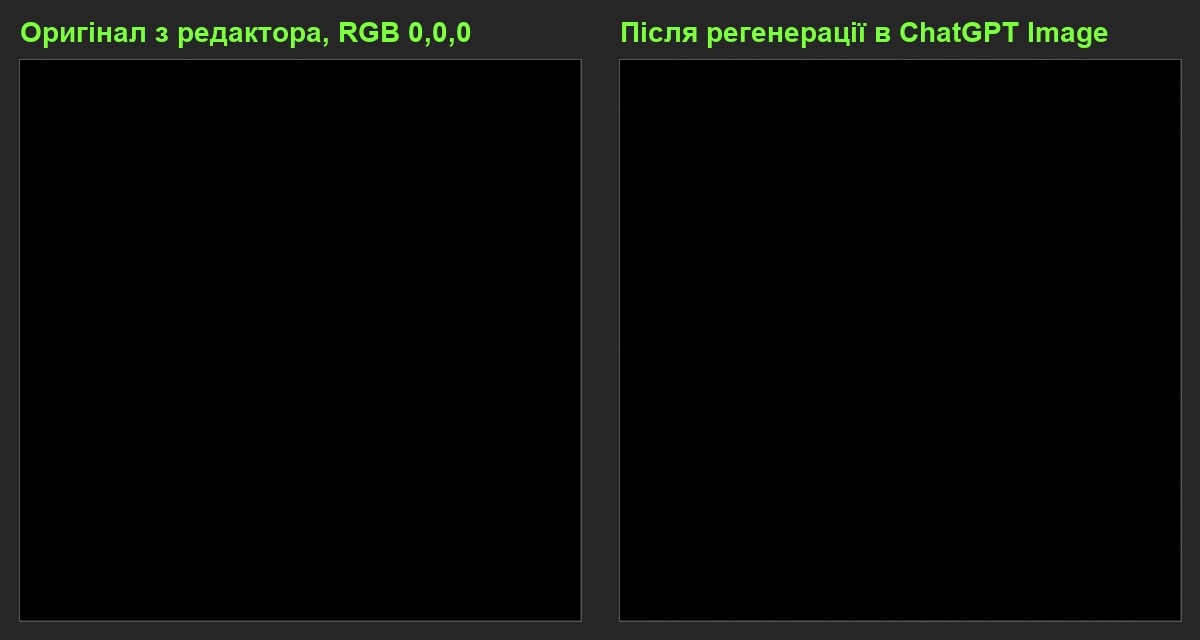
Поруч вони однакові, і це вся суть: знак не видно.
Далі він замінив у регенерованому квадраті весь ідеальний чорний на ідеальний білий. Усе, що лишилось на білому, це пікселі, які відрізняються від нуля. Що з них водяний знак, а що звичайний шум регенерації, розділити неможливо: без ключа видно тільки суму.
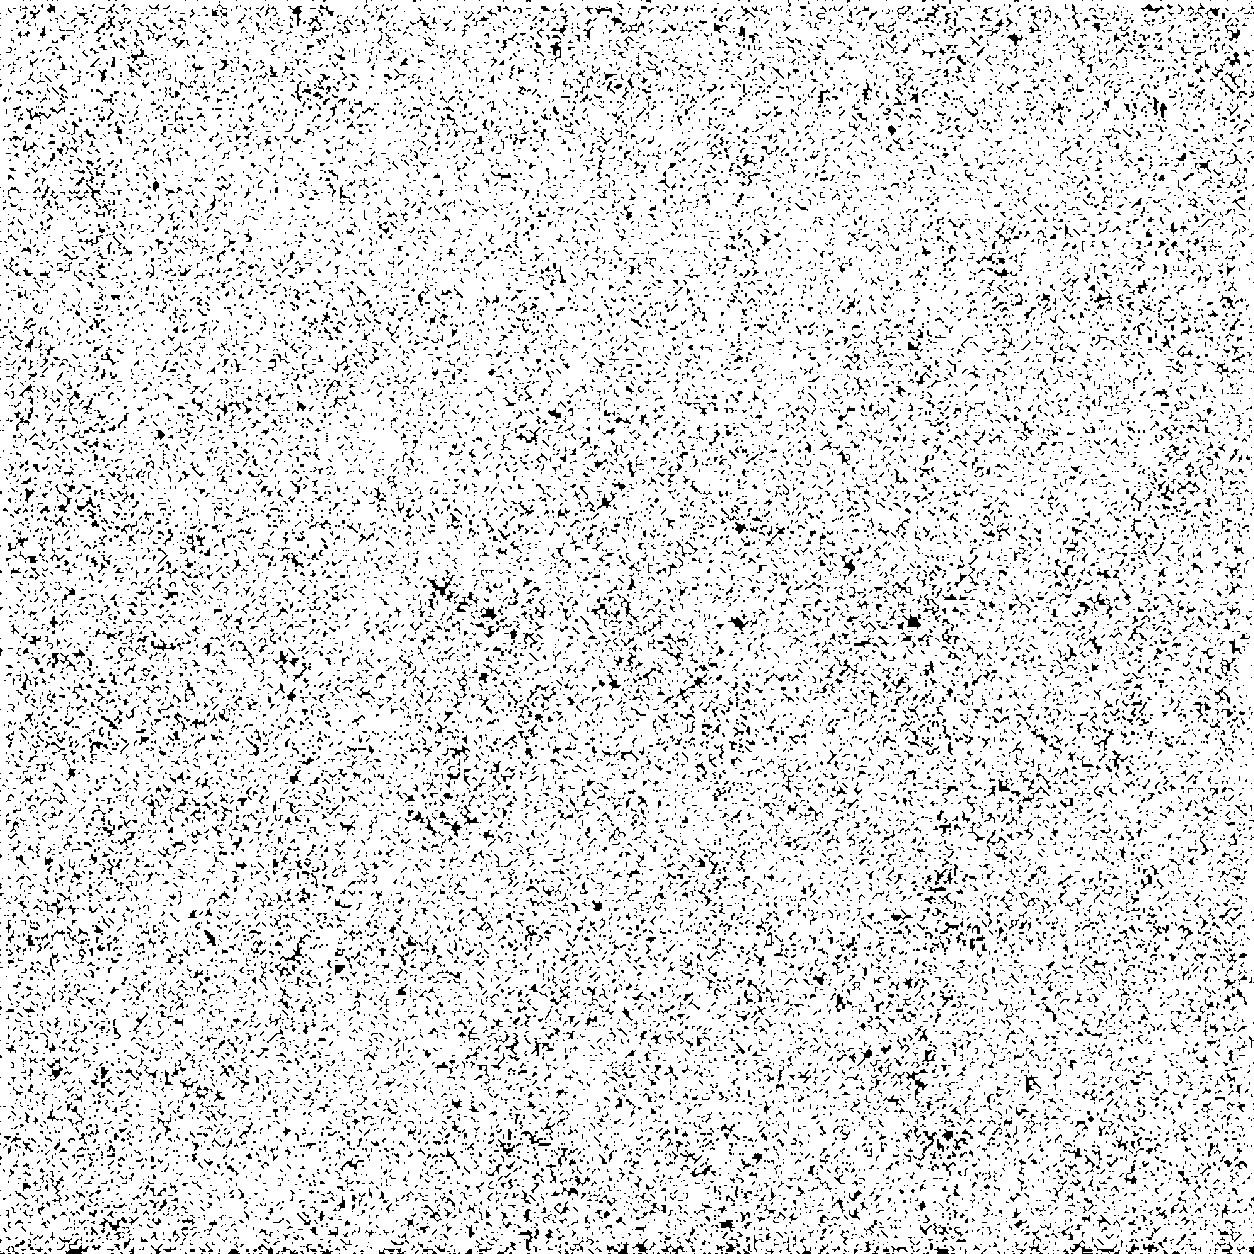
Піпеткою видно, що кожен такий піксель відрізняється від оригіналу на мінус один, нуль або плюс один у кожному каналі RGB. Пікселя з різницею в два Данило не знайшов. Його припущення: після генерації поверх картинки накладається фільтр, який зсуває кольори на один крок за криптографічним ключем. На око це нічого не змінює, бо один крок з 256 людина не бачить.
Якщо сильно підняти контраст і подивитись на кожен канал окремо, видно візерунок цих зсувів. Біля країв зображення змін майже немає, всередині великі плями, схожі на кут і на літеру С, зони заповнені нерівномірно. Чистий шум так не виглядав би, але довести, що це саме знак, без ключа не можна.
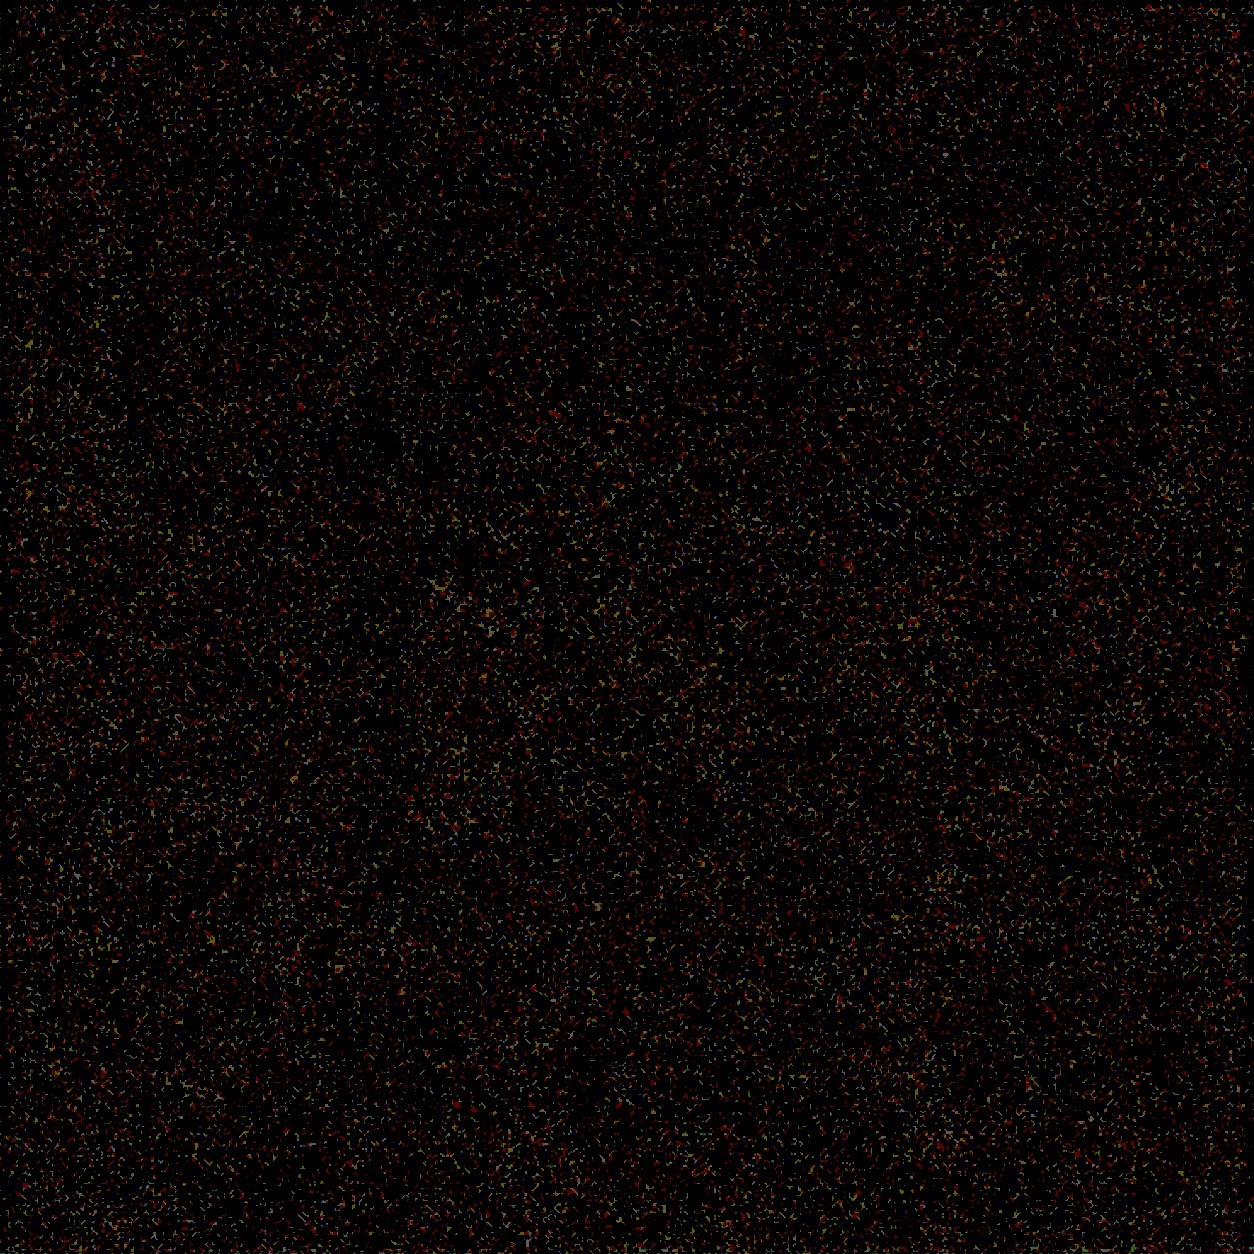
Два застереження. Квадрат генерований ChatGPT, тобто тут знак OpenAI, не Google, але OpenAI приєднались до ініціативи SynthID ще на I/O 2026, а механіка на чорному квадраті виглядає так само. І слайдер до і після для чорного квадрата безглуздий: різницю в один крок кольору слайдер не покаже, її видно тільки піпеткою.
Як зняти знак з картинки: перегенерація в ComfyUI
Руками знак не прибрати. Він розкиданий по всьому зображенню, і зміна контрасту, кольорів чи різкості його не чіпає. Робочий спосіб один: згенерувати зображення заново іншою моделлю, яка знака не ставить, використавши оригінал як референс. Тобто картинка без знака це завжди нова картинка.
Для цього є ComfyUI, редактор графа з вузлів, де workflow це набір з'єднаних операцій. Готовий workflow SynthID bypass лежить на GitHub, автор описує його як дослідження обходу знака на Nano Banana Pro. Старий варіант був простий: ControlNet, картинка на вхід, одна модель на вихід. Новий робить два проходи: спочатку базову картинку перегенерує Qwen Image 2512 з прискорювачем Qwen Image Lightning 4 steps v1.0, потім модель SAM ViT знаходить кожне обличчя, і кожне обличчя окремо перегенерується другою моделлю, Z Image Turbo, у вищій якості з мінімальною втратою деталей. Усе це в стиснутому форматі GGUF, щоб влізти в пам'ять однієї відеокарти. Решта вузлів дрібні: конвертація форматів, фільтри, маски з рамок, завантаження моделей, тому граф виглядає страшнішим, ніж є.
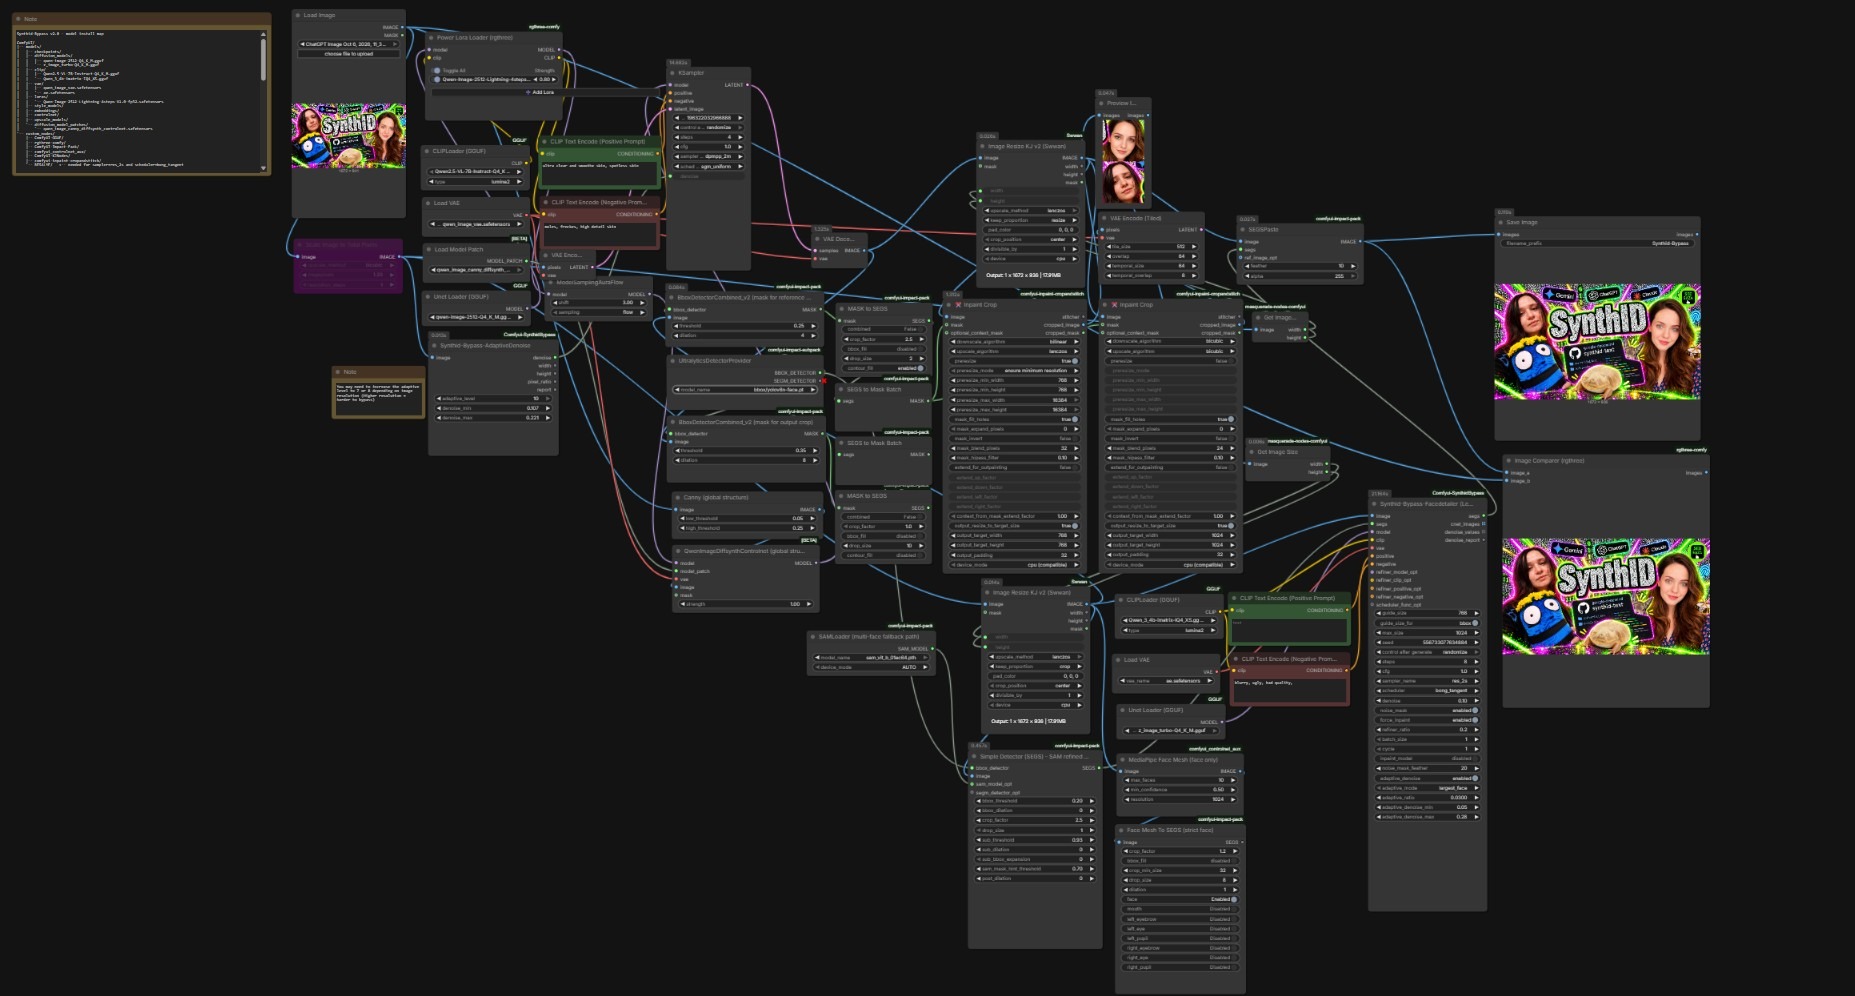
Вузол Image Comparer наприкінці workflow показує оригінал і результат з повзунком посередині:
Моделі з відкритими вагами зазвичай китайські. У китайських вендорів може бути власний аналог SynthID, і впевнено сказати, що його нема, ми не можемо. Але якщо він є, то ставиться на сервері вендора через API, а в ComfyUI крутяться самі ваги, і там його точно немає. Якщо модель відмовляється генерувати потрібне, на Hugging Face є версії без цензури, їх називають abliterated або uncensored: з них прибрали шари, що відповідають за відмови. Яка модель краща, залежить від вашої ніші й від того, на чому її тренували.
Ось пейзаж, згенерований моделлю зі знаком, і та сама сцена, перегенерована в ComfyUI без знака. Тягніть повзунок:
 З SynthIDБез SynthID
Якість трохи падає, бо друга модель дешевша. Її можна підняти: вимкнути прискорювач Lightning, увімкнений у workflow за замовчуванням, і дати моделі 30 кроків замість 4. Різниця помітна, але генерація приблизно в 7,5 раза довша.
Витрати. Усе рахувалось локально на відеокарті з 16 ГБ пам'яті. Спочатку одне зображення займало близько 200 секунд, після налаштування Данило дійшов до 40 секунд на фотографію. На 12 ГБ, можливо, теж піде, ми не перевіряли. На початку ComfyUI може раптом заявити, що на одну картинку потрібно 27 хвилин: це не від workflow, таке іноді трапляється через зовнішні фактори і лікується перезавантаженням. На 500 картинок рахуйте самі. Можна винести це на орендований сервер і навіть зробити з цього сервіс: ті, що продаються зараз, ми дивились, і жоден не додав модуль для тексту, деякі навіть обличчя не обробляють.
Де це ламається: обкладинка нашого стріму
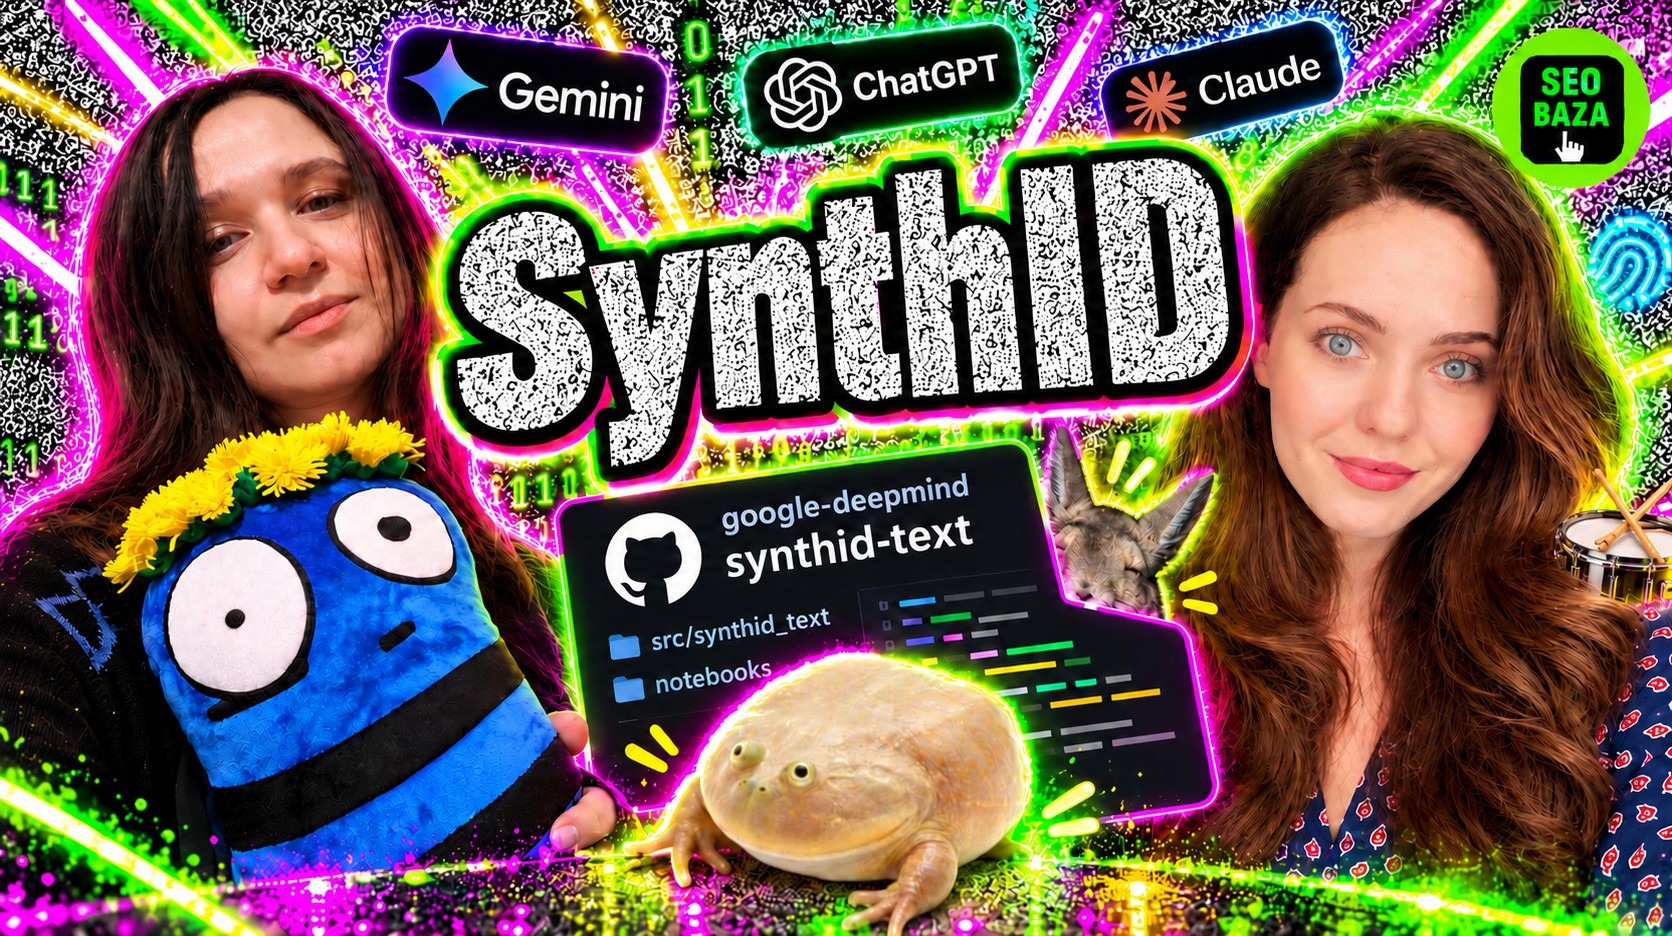
Обкладинку стріму ми згенерували в ChatGPT Image, і на ній, крім двох облич, багато тексту: бейджі Gemini, ChatGPT, Claude, назва репозиторію synthid-text, логотип SEO BAZA. Спроба прогнати її через той самий workflow показує межу методу.
Перша спроба: знак зник, але текст поплив. Логотип перетворився на SED EAZA, назви папок у репозиторії стали нечитабельними.
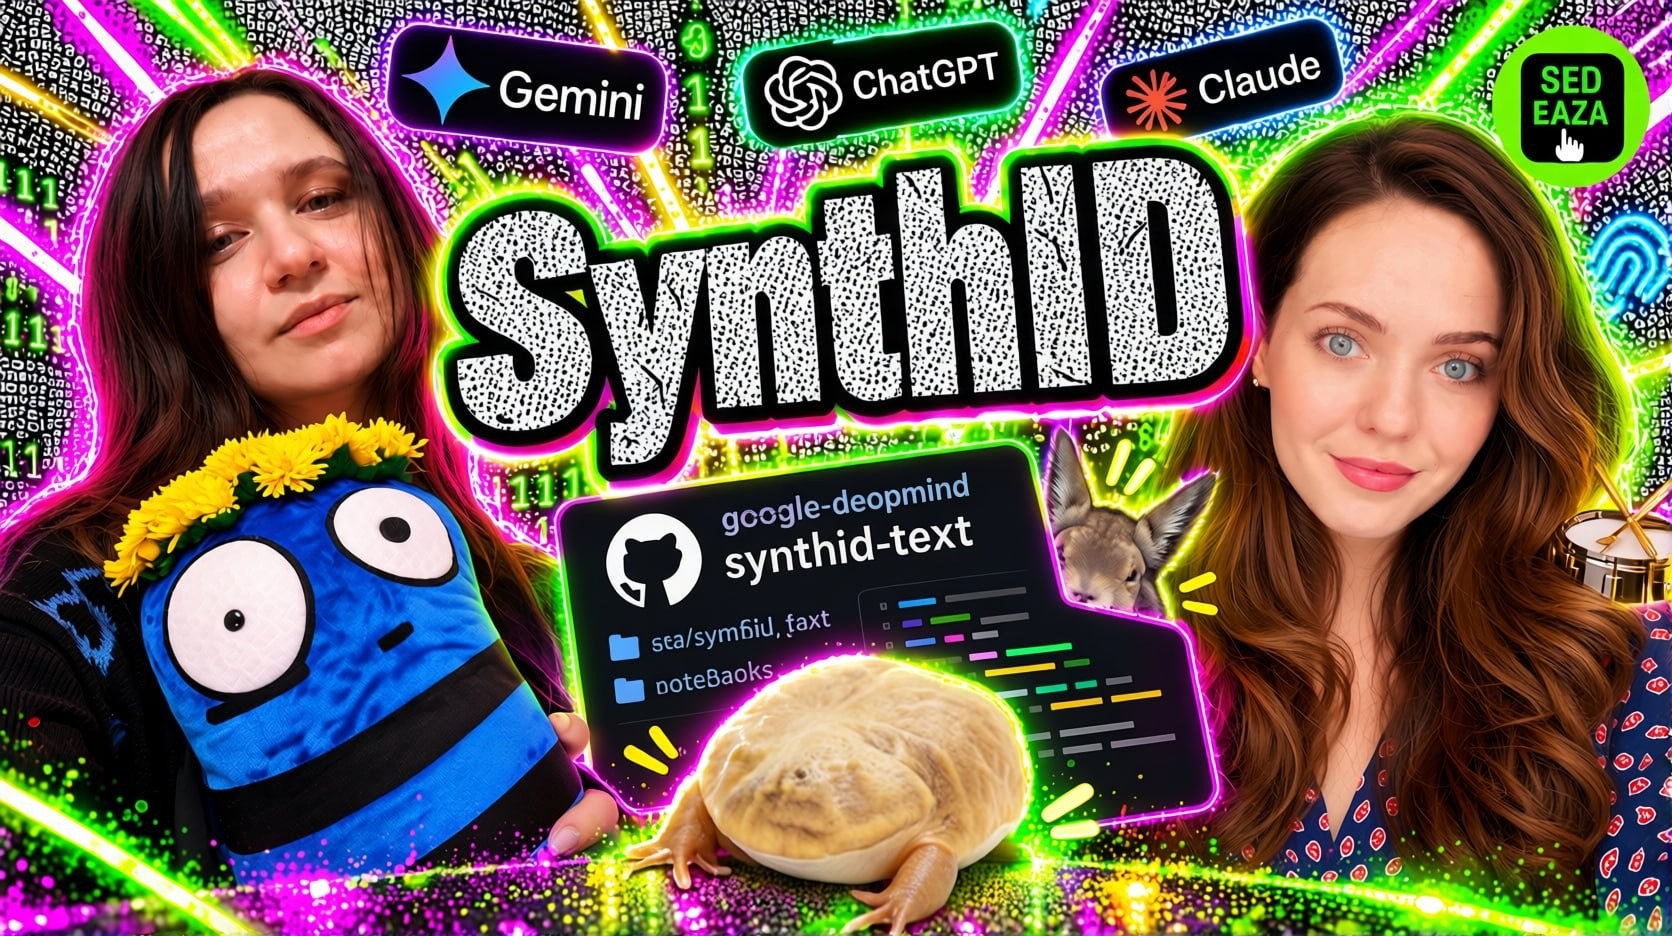 Оригінал зі знакомБез знака, текст зіпсутий
Друга спроба: налаштування під кращу якість, текст майже цілий, але знак лишився. Приблизно так буває з половиною складних зображень: workflow копіює оригінал надто точно і разом із ним копіює знак, тоді картинку треба ганяти ще раз.
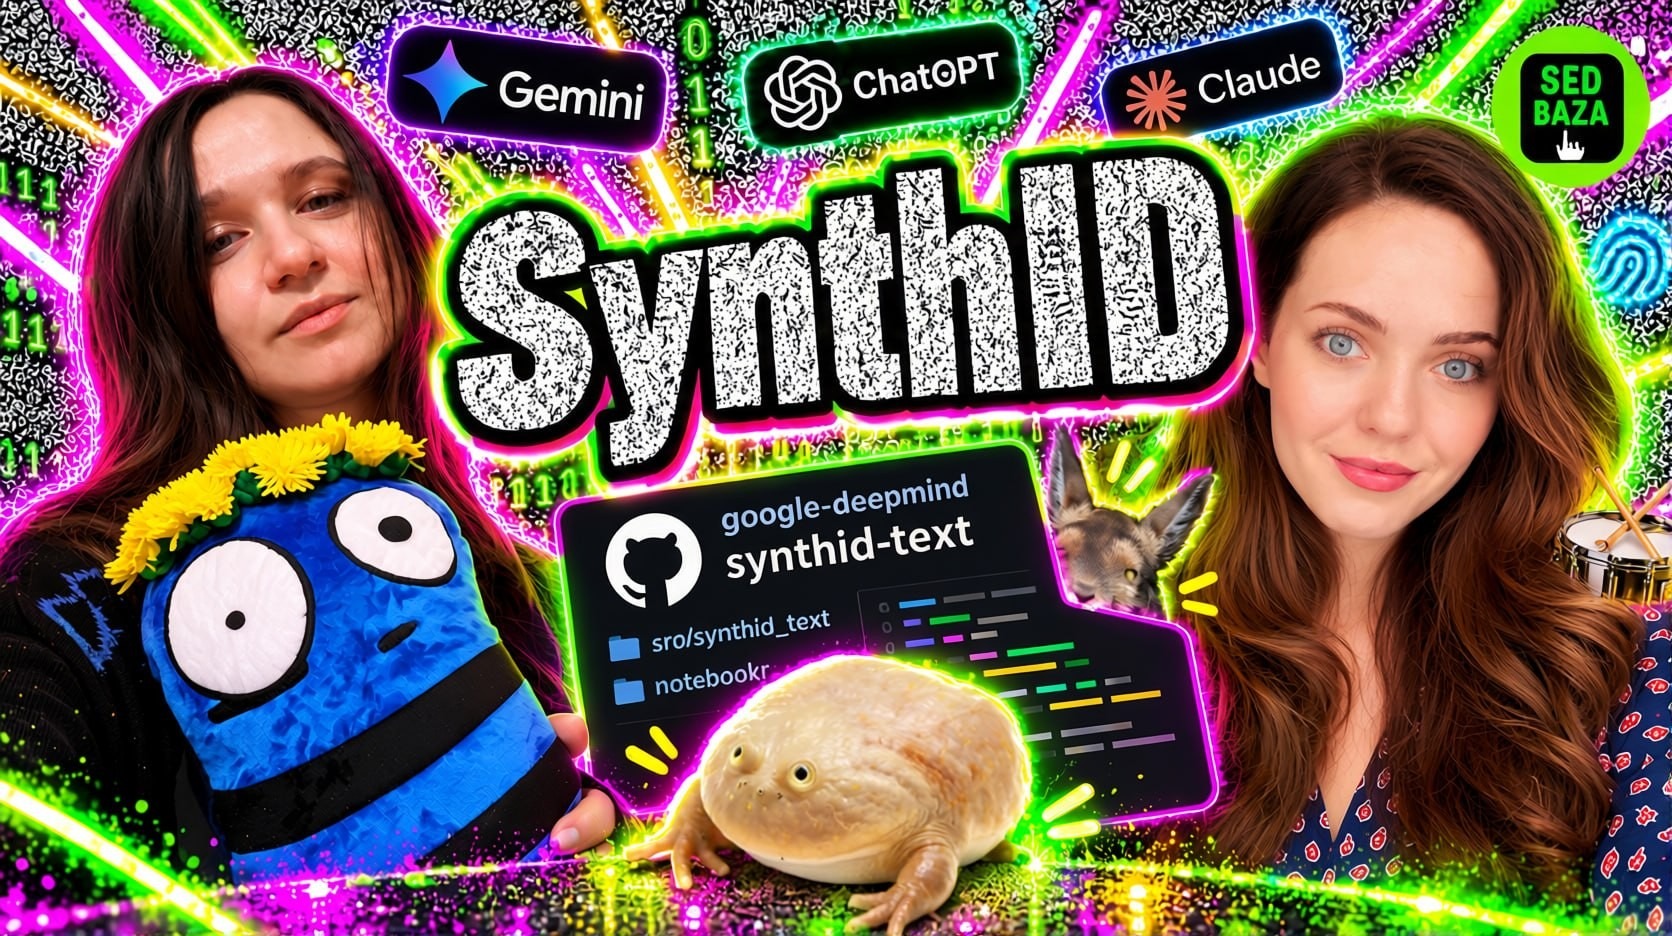 ОригіналКраща якість, знак лишився
Третя спроба з сильною обробкою знак прибрала, але від обкладинки лишились тільки обличчя на сірому рельєфі.
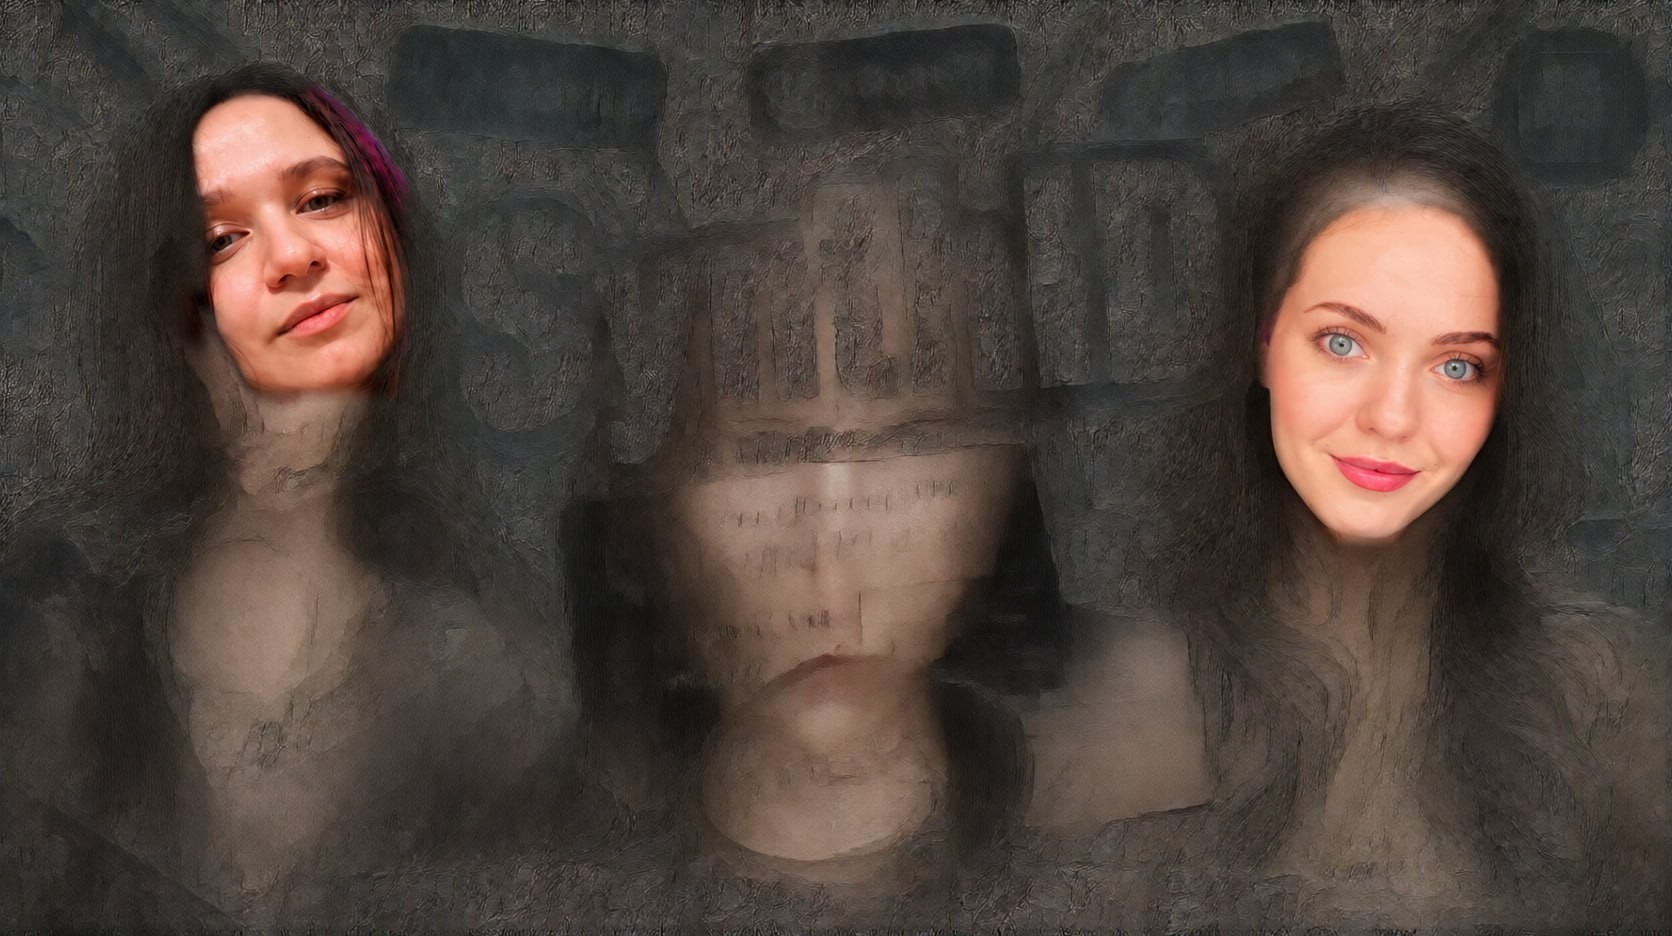
Тому обкладинка на YouTube вийшла зі знаком. Висновок для workflow: картинки з текстом потребують окремого модуля для перегенерації написів, інакше вони або розсипаються, або йдуть на нескінченне друге коло. Для зображень без тексту й без дрібних елементів метод працює стабільно.
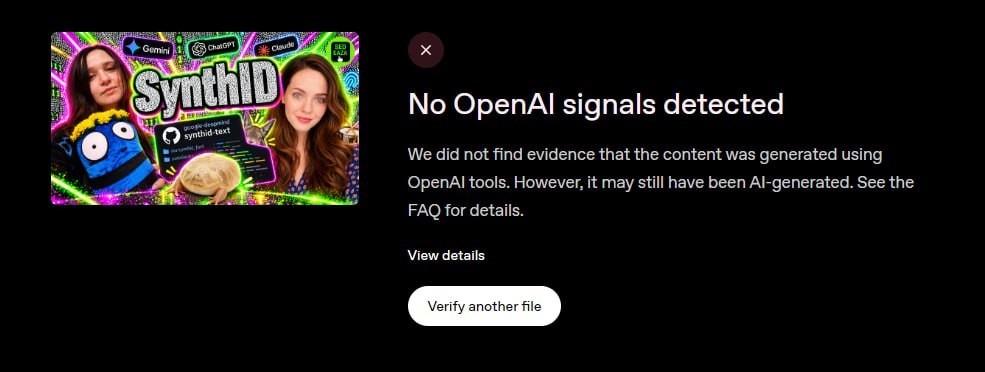
Перегенеровану обкладинку ми завантажили у верифікатор OpenAI, і він сигналів OpenAI не знайшов: для їхнього детектора картинка вже чужа.
Є й інший спосіб, який Саша Хілова показала на стрімі. Ryan Whitwam з Ars Technica імітував 300 циклів пересилання картинки: скрипт на бібліотеці Pillow щоразу випадково стискав і масштабував зображення з Nano Banana Pro і подавав результат на наступне коло. Після 300 циклів картинки перетворились на розмиті плями, а знак у повному кадрі лишався, його досі читав Gemini. Зламало знак лише обрізання. Після 300 циклів вистачало відрізати 20% по краях, а якщо обрізати картинку наполовину, знак зникав уже приблизно на 250-му колі. Тобто обійти вдалось тільки тоді, коли картинка вже ні на що не годилась. Ще два спостереження з того тесту. Gemini дає приблизно 10 перевірок на день і блокує раніше, якщо завантажувати схожі картинки. А в липні детектор у чаті Gemini не бачив знак OpenAI, і навпаки, хоча технологія під сподом та сама. З 7 жовтня портал synthid.com, за заявою Google, читає і знаки партнерів, серед них OpenAI. Про обрізання картинок як зловживання є і в інструкції для асесорів Google, Саша перевіряла.
Чи карає Google за згенеровані картинки
Google оголосили, що розпізнавання SynthID і C2PA заходить у пошук і Chrome, тобто згенеровані зображення у видачі будуть позначені. Прямих доказів, що згенерована картинка шкодить ранжуванню, ми не бачили. Єдина згадка: сайти, які просіли на серпневому спам-апдейті за масове виробництво контенту, масово використовували картинки з Nano Banana. Сама по собі згенерована картинка трафік не вбиває, вона має бути поєднана ще з чимось.
Межа проходить по обману користувача. Згенеровані фото товарів, видані за справжні, або згенеровані фото квартир на сайті нерухомості це погано, і Google так чи інакше зрозуміє, що зображення згенероване. Діаграми, схеми й ілюстрації до статей це нормально, ми на SEO Baza так і робимо.
Для текстів правила ті самі, і Google 1 жовтня вписали їх у документацію: вручну перевіряти факти в усьому AI-контенті, включно з тайтлами, описами й alt-текстами, а асесори оцінюють, скільки зусиль несе сторінка. Три правила для контенту: бути джерелом, бути складним для повторення і пройти перевірку фактів. Генерувати можна й далі, просто з кожним роком це коштуватиме більше зусиль на автоматизацію перевірок.
Текст: як знак потрапляє в токени
З текстом просто від балди перегенерувати не вийде. Навіть заміна кожного четвертого слова теж не спрацює. Тому що деякі варіанти, особливо фактологічні, строго детерміновані, там немає багатого вибору поміж різними синонімами або формулюваннями. Наприклад, якщо людина йде на роботу, то якось по-іншому це сказати без втрати сенсу майже неможливо. А там, де декілька слів можуть підходити майже однаково, який гарний, чудовий або хороший день, модель уже може застосувати шифр. Детектор, який має ключ до цього шифру, перевіряє готовий текст і вираховує, як часто слова збігаються з вибором слів у ключі. У тексті, який пише людина, це зазвичай не більше половини випадків, а от у відміченому водяним знаком буде помітно більше. Але без ключа визначити це дуже точно неможливо. Покроково, з прикладом і поясненням, чому в коді знака майже нема, ми розбирали в серпні.
Звідси перший наслідок, який Данило сформулював найкоротше: детектор дивиться тільки на слова, чи міг такий ланцюжок вийти з цим ключем. На структуру, абзаци, зміст і авторство він не дивиться. Тому скільки б свого тексту ви не дописали після згенерованого шматка, шматок лишається поміченим, бо його слова ті самі. І навпаки, якщо переписати майже кожне слово, а структуру й абзаци лишити, детектор знака не знайде.
Що знак переживає, а що ні
Google пишуть у документації: знак витримує обрізання тексту, заміну кількох слів і легкий переказ, він слабкий на фактологічних відповідях, бо там мало вільних розвилок, а після ґрунтовного переписування або перекладу впевненість детектора сильно падає. Anthropic про свій знак кажуть те саме: легку правку переживе, повне переписування зітре. Детектор Anthropic, за описом компанії, вміє лише сказати, що Claude, схоже, брав участь, і не відрізняє текст, який Claude написав, від тексту, який він тільки відредагував, а на коротких текстах, фактах і коді працює погано.
Що пробували ми. Саша на стрімі: синонімізація, переклад туди й назад, вирізання речень і абзаців на початку та в кінці. Олеся: теорію про заміну кожного третього чи четвертого слова, бо знак нібито сидить у вікнах з трьох-чотирьох слів. Не підтвердилась: або знак лишається, або текст псується.
Що показали чужі досліди. Дослідники з Queen's University перевірили чотири способи прибрати помітку на відкритій версії SynthID-Text. Переклад іншою мовою і назад найдієвіший: після подорожі через китайську детектор упізнає лише два помічені тексти з трьох. Якщо втопити помічений уривок у вдесятеро більшому людському тексті, детектор перестає розрізняти взагалі. Переказ іншою моделлю послаблює сигнал, але помітку здебільшого ще видно. Заміна частини слів синонімами не працює. Є й прицільний спосіб: дослідники з ETH Zurich показали викрадення водяного знаку, коли помічену модель ганяють запитами, будують наближену карту слів, до яких вона тяжіє, і міняють саме їх, за менше ніж $50 на запити. Саме тому ключі нікому не дають, хоча цього вимагає той самий AI Act. Ключ як пароль компанії: з ним можна підробити знак і помітити будь-який чужий текст як згенерований. Тому розробники обіцяють API для перевірки, а ключ лишають у себе.
Ми прогнали власний маленький тест на відкритому SynthID-Text зі своїм ключем: маленька Gemma 4 на звичайному процесорі, 4 тексти. Це лише пілот, але картина та сама. Знак сидить там, де модель могла вибрати з кількох слів: де вибору майже нема, сигналу теж майже нема, а де вибір найширший, сигналу всемеро більше. Близько 71% сигналу припадає на слова, які можна замінити синонімом. Якщо замінити кожне таке слово навмання, зникає 95% сигналу, але текст перетворюється на мотлох: вода стає сечею, а тепло жаром. Якщо міняти акуратно, зі збереженням сенсу, приблизно кожне восьме слово, зникає лише 16%. Тобто те, що тримає текст читабельним, тримає і знак. Данило дійшов того самого висновку: міняти треба майже кожне слово, і тоді вже не важливо, якою моделлю.
Хто мітить текст і де взяти чистий
- Google мітить текст Gemini з 2024 року, у травні 2025 сказали про це офіційно. Будь-яка модель Google через API ставить знак за замовчуванням, тому Gemma, якою люди люблять переписувати, має запускатись не через Google: співробітник Google підтвердив на форумі розробників, що текст із Gemini API помічений, а знак додається на серверах, у вагах моделі його нема.
- Anthropic мітять весь текст Claude з 2 серпня 2026: чат, API, Claude Code, через AWS, Google Cloud і Microsoft Foundry, по всьому світу. З 30 вересня знак увімкнений у Fable 5, Sonnet 5 і Opus 4.8, старші моделі отримають його до 2 грудня. Під сподом та сама технологія SynthID-Text 2024 року, ключ свій. Обіцяний у серпні детектор досі в закритому доступі для окремих організацій.
- OpenAI два роки тримали готовий текстовий знак у шухляді і запустили його 5 жовтня 2026, за два дні до нашого стріму. Метод зветься textGrain, і це знову статистичний сигнал у виборі слів, за їхніми тестами не гірший за SynthID для тексту. ChatGPT і Codex отримають знак протягом кількох тижнів і тільки в ЄС. В API знак вимкнений за замовчуванням, і клієнти по всьому світу можуть увімкнути його самі для окремих моделей, тобто текст з OpenAI API поза ЄС лишається без знака, поки ви самі не попросите. Детектор дають тільки схваленим дослідникам і організаціям, і він каже лише, чи є знак OpenAI. Їхні ж цифри про стійкість: на уривках з 400 токенів детектор ловить близько 95%, на 200 токенах близько 80%, на математиці суттєво менше; заміна 10% слів синонімами опускає виявлення з 92% до 66%, заміна 25% до 17%. Зображення й аудіо OpenAI мітять давно, і там детектор публічний.
- Моделі з відкритими вагами чисті, якщо їх не крутить вендор: знак ставить сервер, не модель. Ми робили три версії новини про AI Mode через Qwen і Kimi на сторонньому хостингу без участі Alibaba і Moonshot, і локальна модель на своєму залізі теж чиста, тільки повільна.
- Кодекс практики до AI Act підписали близько 190 сторін, свої знаки будуть у всіх розробників.
- Детектори не бачать чужих знаків: детектор OpenAI не бачить знак Google, детектор Google не бачить знак OpenAI, це для картинок перевірили в Ars Technica, а чи мітять щось китайські API, не перевіряє ніхто. Для медіа це з 7 жовтня частково закрито порталом synthid.com, для тексту ні. Детектори AI-тексту без ключа, усі ці GPTZero, до SynthID не мають стосунку: вони вгадують за статистикою слів, і після ChatGPT слово delves у наукових анотаціях стало траплятися у 28 разів частіше, оце і є їхня база.
Публічний репозиторій synthid-text від DeepMind лишається єдиним місцем, де можна перевірити свої методи: помітити текст своїм ключем і пробувати знак зняти. Робочі версії в Google і Anthropic, судячи з усього, недалеко від нього відійшли. Українською він працює погано, тестувати краще на великій мові.
Що з цим робити
- Картинки без тексту й дрібних елементів: перегенерація в ComfyUI працює, на 16 ГБ це від 40 секунд до кількох хвилин на картинку.
- Картинки з текстом: або додайте модуль для написів, або лишайте знак, як ми на обкладинці.
- Перед публікацією згенерованої картинки перевір її на synthid.com: побачиш те саме, що бачить Google.
- Згенеровані ілюстрації до статей не ховайте, згенеровані фото товарів не видавайте за справжні.
- Текст без знака дають моделі з відкритими вагами на хостингу без Google і без вендора, локальні моделі і поки що OpenAI API поза ЄС, де знак треба вмикати самому.
- Якщо текст пройшов ручну перевірку фактів і редактуру, він і так переписаний настільки, що знак слабшає, і це ті самі зусилля, яких вимагає Google.
Відео повністю: SynthID для SEOшників: що це і як працює