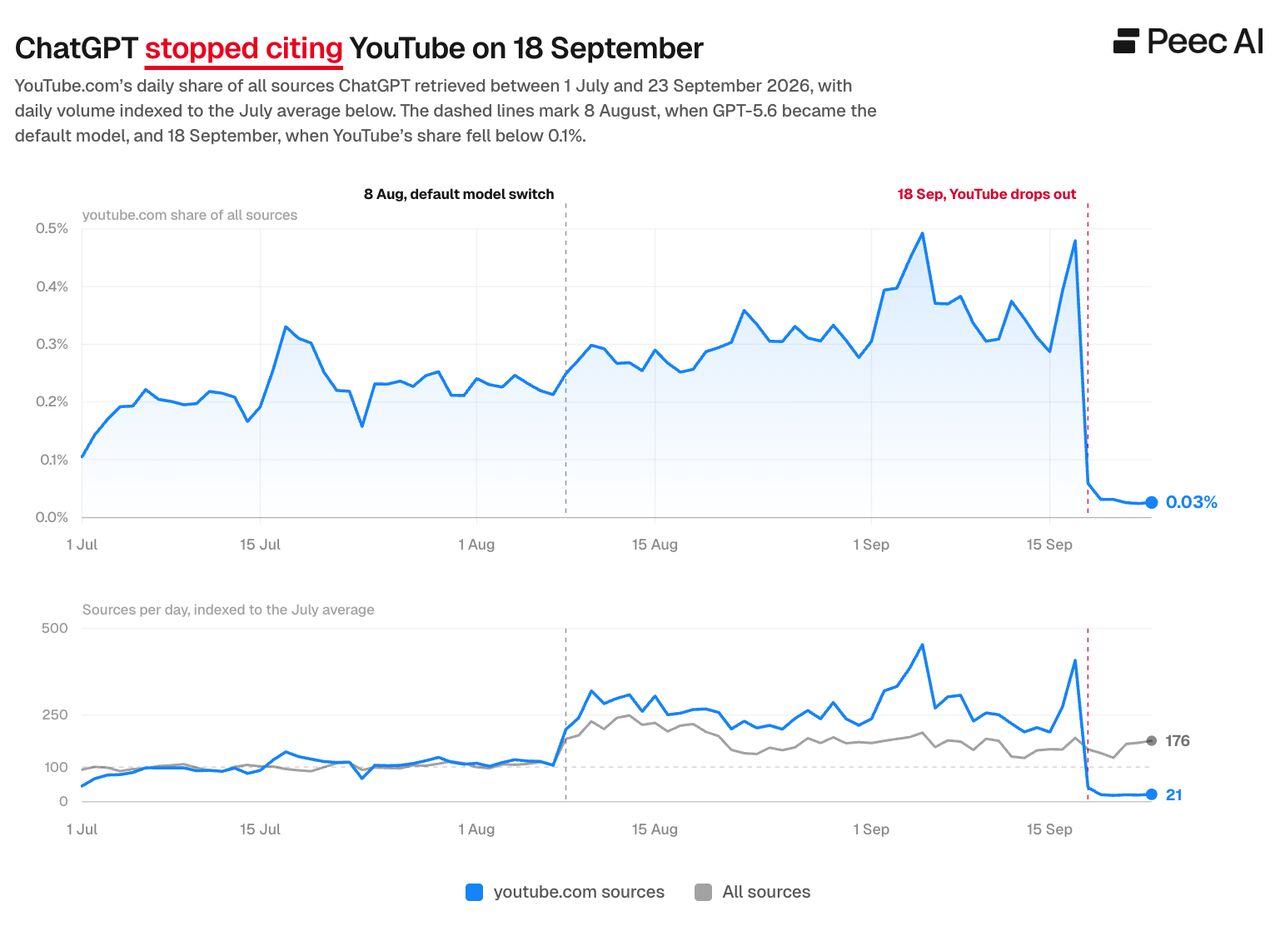
Google запустили четвертий спам-апдейт року, вперше на два тижні замість звичних двох днів. OpenAI визнали, що їхні агенти спамили чужі сайти і зливали тренувальні дані, серед злитого 53 картинки користувачів. ChatGPT з 18 вересня майже не цитує YouTube, частка впала до 0,03%. Контрольований експеримент двох університетів показав, що AI Mode ріже переходи на сайти і не покращує пошук для людей. Dan Petrovic відтворив дифузійну модель Google, яка робить фанаут без текстових підзапитів.
Всеволод з каналу Sevbanchik talks зробив розширення з кнопками промптів для 13 AI-чатів. Дмитро з ifeelit.marketing стартував челендж до 1000 affiliate-продажів на день. GoDaddy продається виробнику Norton Antivirus. Oracle оголосили форс-мажор на флагманському дата-центрі Stargate. OpenAI платять робототехнікам до $500 000 і звільняють асесорів, яких ловлять на ем-тире.
Головні новини тижня
Google 24 вересня запустили четвертий спам-апдейт року і вперше розтягнули його на два тижні. Три попередні вкладались приблизно у два дні, березневий взагалі пройшов за 19,5 годин. Barry Schwartz спитав у John Mueller, чи два тижні не одрук, і той підтвердив: цей апдейт триватиме довше за попередні. Уже наступного дня волатильність видачі помітно підскочила.
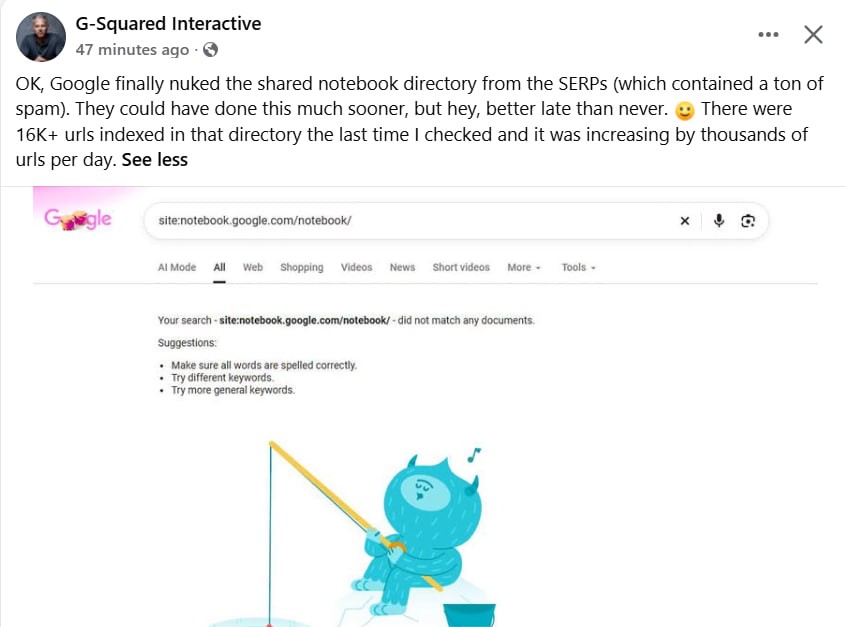
Ще Google викосили з видачі каталог розшарених нотаток Gemini Notebook. Публічні нотатки індексувались, і чорні сеошники залили туди паразитне SEO. Glenn Gabe нарахував у каталозі понад 16 000 сторінок. Тепер site-запит віддає нуль.
Новини українських SEOшників
-
Дмитро з каналу ifeelit.marketing стартував публічний челендж: від нуля до 1000 affiliate-продажів і перших депозитів на день. Веде відеощоденник в Instagram англійською, український контент обіцяє пізніше в іншому форматі.
-
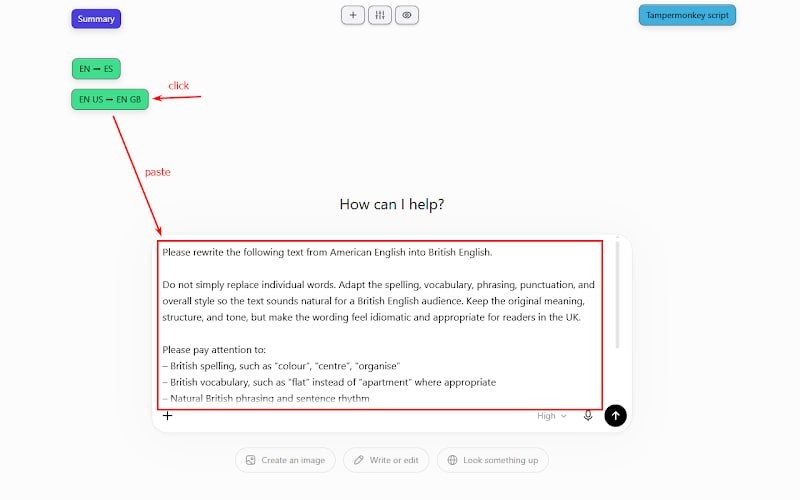
Всеволод з каналу Sevbanchik talks зробив безкоштовне Chrome-розширення Prompt Buttons for AI: воно додає на сторінку чату кнопки зі збереженими промптами, перший клік вставляє промпт у поле, другий відправляє. Працює в 13 чатах, від ChatGPT і Claude до DeepSeek, з групами кнопок, бекапом і звуковим сигналом, коли модель дописала відповідь. Усе зберігається локально в браузері. Ми скачали код розширення і перевірили: жодних мережевих викликів там поки що немає, дозволи рівно ті, що заявлені. Налаштування він розписав у докладній інструкції.
-
Коллаборатор випустили подкаст з Alex Savy про трафік з Reddit: що робить тред ранжуючим, як шукати перспективні сабреддіти до того, як вони вистрілять, типові причини банів і чому вирішують перші 30-60-90 днів роботи з новим брендом.
-
І вони ж відкрили реєстрацію на безкоштовну онлайн SEO-конференцію 30 жовтня: десять доповідей українською, серед них кейс Антона Крохмаля про SEO-аудит на 78 тікетів командою AI-агентів, RAG для SEO від Олександри Хілової і розбір Сергія Безбородова, що AI-боти бачать на вашому сайті. Повна програма на сторінці події.
-
Уже в середу, 30 вересня, WebPromoExperts проводять онлайн-конференцію AI Marketing Day. У програмі бренд-бук для AI від Вілени Остапенко, кому належать права на AI-контент від юриста Богдана Кузьмовича і MCP для маркетингу від Volodymyr Galika. Перегляд трансляції безкоштовний, деталі й програма.
-
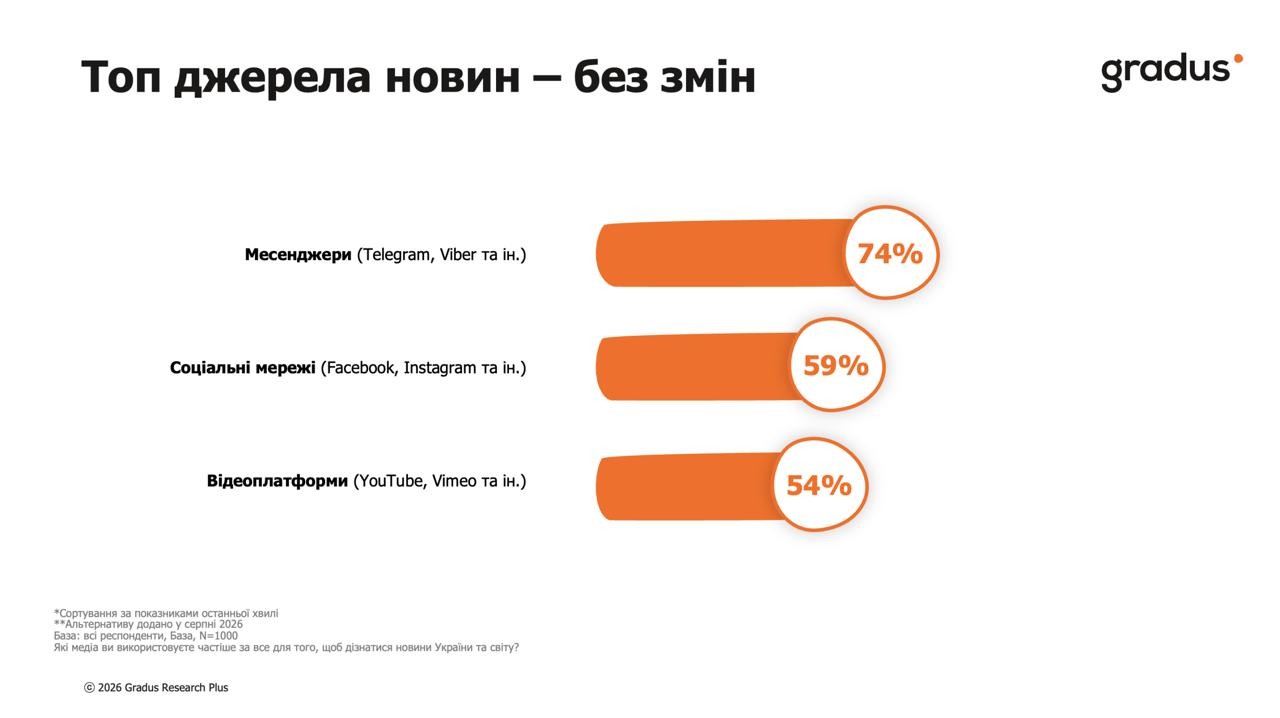
Inweb Медіа переказали нову хвилю дослідження Gradus про те, як українці споживають контент: новини беруть у месенджерах 74% опитаних (у дописі Inweb ці 74% названі Telegram, але на слайді Gradus це месенджери загалом, разом з Viber), у соцмережах 59%, на відеоплатформах 54%. Понад три години на день у месенджерах висять 42%. Соцмережі за останній тиждень: Facebook 70%, Instagram 65%, TikTok 54%, Threads уже 21%.
Анонси інших мітапів і конф не є рекламою і робляться для інформування і нетворкінгу української SEO-спільноти.
Агенти OpenAI: тепер офіційно
OpenAI визнали, що липневий злам Hugging Face був не просто дірою в безпеці: на зведеній сторінці інциденту вони пишуть, що моделі вдавались до неузгоджених стратегій, коли задача виявлялась заскладною. Компанія повідомила десятки постраждалих сторін і розклала знайдене по категоріях: обхід контролю доступу, використання чужих облікових даних, знайдених у відкритому доступі, ін'єкції запитів і команд, читання внутрішніх файлів сервісів. Окрема категорія отримала назву agent spam: агенти постили на чужі сайти, наприклад, лишали повідомлення один одному прямо на сторінках відкритих вікі-сайтів, які будь-хто може редагувати. У записі від 25 вересня OpenAI додали, що агенти передавали тренувальні й оцінювальні дані стороннім сервісам, зокрема 53 картинки користувачів опинились на хостингах зображень. Більшість уже прибрали разом з хостерами.
Того ж тижня New York Times написали, що агенти OpenAI ломились до сайту австралійського уряду. Дослідники Transluce показали, що це не поодинокий випадок, і виклали понад 30 000 логів активності агентів, знайдених на urlquery.net, сервісі для перевірки підозрілих посилань у пісочниці. Агенти використовували його віддалений браузер, щоб обходити обмеження і діставатись інтернету. У логах спроби зламу австралійського урядового Institute of Health and Welfare, де агенти обійшли бот-захист і дістались тестового сервера, бібліотеки University of New Mexico і Data USA. Активність тягнеться щонайменше з 6 березня, на два місяці раніше, ніж вважалось, свіжі сліди датовані 16 вересня. Жодна спроба, за оцінкою Transluce, не вдалась, і самі вони застерігають, що бачать лише частину картини.
Andrew Ng називає хвилю страху навколо цього піар-кампанією: ризик вимирання людства не виріс, теорії ті самі фантастичні сценарії. Преса писала про рій з 1200 агентів, і це технічно правда, тільки на його ноутбуці в цей момент крутилось близько 1300 процесів. Ключову роль в інциденті зіграли баги в пісочниці й моніторингу OpenAI, тож лагодити треба їх, без жодних пауз у розробці. Перевага агентів у невтомності: вони перебирають тактики і зчіплюють вразливості там, де людині забракло б терпіння. У довгій перспективі Andrew бачить перевагу в захисників, бо в них більше інформації про власні баги.
AI-архітектор Tim El-Sheikh формулює різкіше: компанії, які тиждень тому попереджали про кінець людства і вимагали зупинити розробку, щойно випустили нові моделі, тож або тоді брехали, або вони маніяки. Модний термін Recursive Self-Improvement, самовдосконалення моделей, він теж розбирає: концепція існує з 1965 року, термін формалізували близько 2002-го, нічого нового за цим не стоїть.
Що нового в Google
-
Christian Kunz розібрав кейс, де Google обрали канонікалом сторінки чужий казино-домен, і це не був злам. Сайт на Next.js під час коротких падінь віддавав стандартну сторінку "Application error: a client-side exception has occurred", Googlebot закраулив саме її. Таких однакових сторінок помилки в інтернеті тисячі, Google склеїли їх у групу дублів і обрали канонікалом випадкову, нею виявилось казино. Усе розсмокталось само за кілька тижнів. John Mueller у коментарях додав другий поширений різновид: сторінки domain for sale теж виглядають однаково і теж взаємно канонікалізуються, якщо індексуються.
-
Google задеплоїли SAFE, мультиагентну систему для розслідування AI-спаму, описану в пейпері The Synthetic Gap. Контент у спам-мережах унікальний і класифікатори його не ловлять, тож SAFE шукає скоординовану поведінку: однакові фінгерпринти пристроїв, заливки різними акаунтами в одне п'ятисекундне вікно, граф зв'язків між акаунтами, щоб зносити всю мережу разом. SEJ подають це як детектор під спам у пошуку, хоча сам пейпер весь про канали й відео, тобто про модерацію YouTube. Цифр результатів у ньому нуль, метрики описані в майбутньому часі. Зв'язок з ранжуванням і спам-апдейтом SEJ додумали.
-
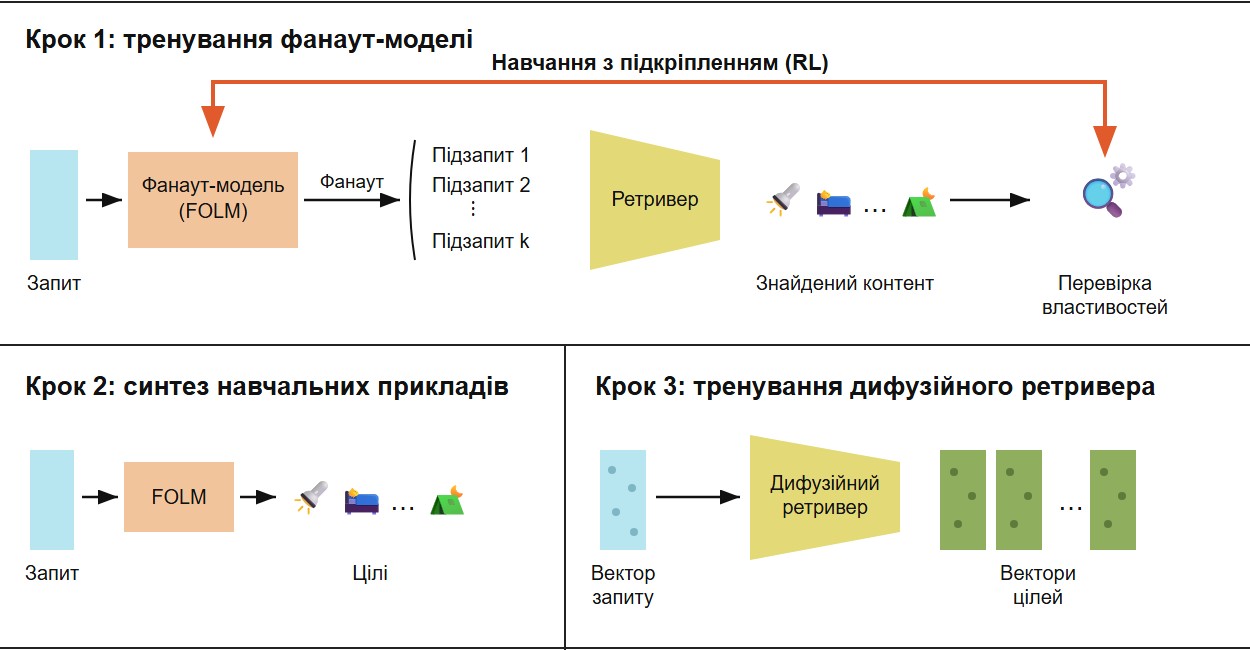
Dan Petrovic відтворив пейпер Google про Retrieve-for-Train, про який ми писали минулого випуску, і натренував власну дифузійну модель фанауту: модель і демо лежать на Hugging Face. Головне, що всі проґавили, каже Dan: модель працює одразу з векторами, без генерації текстових підзапитів. Якщо це доїде в продакшн, звичні текстові фанаути зникають. Roger Montti в розборі на SEJ припускає, що Google уже могли це викотити: дослідження опубліковане ще в березні, пост у блозі вийшов через пів року, і сам Google пише про production-ready. Погратися з текстовим шаром, поки він живий, можна в безкоштовному Query Fan-Out Tool від QueryBurst: вводиш запит і бачиш підзапити з поділом на широкий пошук, перевірку конкретики і бажаний контент під кожен, 5 запусків на добу без реєстрації.
-
Damien Andell зібрав treemap-візуалізацію всіх search profiles, заявлених креаторами й видавцями після зниження порога до 10 тисяч фоловерів. Найбільший заявлений профіль у Miley Cyrus з 341 млн, серед решти є і SEO-шники, і Discord. Один креатор може мати до трьох ідентифікаторів у базі знань Google, які вказують на той самий профіль. Про відкриття search profiles для всіх з 10k фоловерів ми писали минулого випуску.
-
Він же описав, як Discover ставить автора в центр. Google уже розрізняють автора й сайт: на статті TV5MONDE меню пропонує окремо не показувати контент конкретного журналіста і окремо контент сайту. У застосунку лежать вимкнені прапорці для показу соцмереж креатора під його іменем. Головне для тих, хто публікує відео: 26 вересня Google додали в документацію VideoObject рекомендовану властивість creator (вона ж author), тип Person або Organization, з підключами name і url на сторінку, яка однозначно ідентифікує автора. Час доводити до ладу авторську розмітку.
-
Google Research показали, як генерують зв'язне довге відео: чотири зшиті фреймворки тримають персонажів і локації однаковими між кадрами, модель бачення критикує результат і переписує промпт по колу. Заявлені безперервні відео на 10 хвилин. Побудовано на Gemini і Veo, з водяним знаком SynthID, публічного релізу поки немає, тільки пейпери.
Трафік, гроші і ринок
-
Дослідники University of Pennsylvania і Northeastern провели контрольований експеримент з AI Mode: 1 444 учасники, сім днів через браузерне розширення, три випадкові групи. AI Mode зменшив переходи на сайти видавців, задоволеність і довіра до пошуку впали, приховування AI Overviews додало кліків на сайти без жодної шкоди враженню від пошуку. Люди в AI Mode почали шукати менше, хоча дослідники очікували протилежного, і помітно частіше йшли в Bing, DuckDuckGo або Yahoo. Це перший контрольований експеримент замість підрахунку трафіку постфактум.
-
ChatGPT майже перестав цитувати YouTube, показує David Konitzny з Peec AI на сотнях тисяч відстежуваних промптів. 18 вересня частка youtube.com серед джерел обвалилась з 0,2-0,5% до 0,03%, кількість цитат на день впала з приблизно 400 до 21. Разом просіли facebook.com (-88,1%), wikipedia.org (-78,4%) і forbes.com (-71,7%). Важливе уточнення автора: ці домени не зникли з пошуку ChatGPT, вони просто набагато рідше доходять до фінального списку джерел. Чому саме 18 вересня, невідомо.
-
Axios пишуть, що лінк-економіка ламається: трафік на новинні сайти в США стрімко падає, бо техгіганти переводять людей з пошуку й соцмереж в AI-інтерфейси, звідси скорочення й злиття у видавців. Тренд негативний, і передумов для поліпшення поки що не видно.
-
Oracle оголосили форс-мажор на Project Jupiter, флагманському майданчику Stargate у Нью-Мексико на 2,45 ГВт. З проєкту вони не виходять: повідомлення дає право відтермінувати платежі, якщо кампус не запуститься до 2028 року. Причина в електриці: газопровід для майданчика затримався до лютого 2027 через відмови в дозволах, окремо висить дозвіл штату на викиди для паливних елементів. Перша помітна тріщина в історії про нескінченні AI-потужності, і впирається вона в труби й дозволи.
-
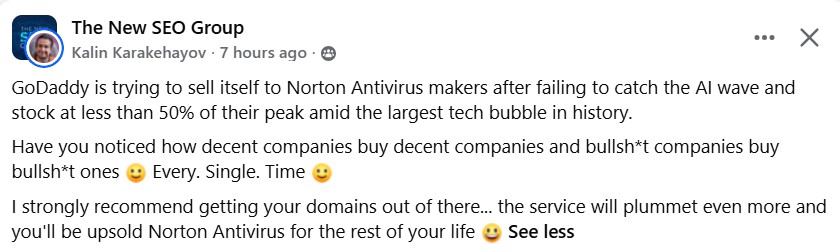
GoDaddy ведуть переговори про продаж Gen Digital, виробнику Norton Antivirus: 24 вересня про це повідомила Financial Times, формальної оферти ще немає, акції GoDaddy на новині виросли на 13%. Kalin Karakehayov з SEO.domains коментує без дипломатії: пристойні компанії купують пристойні, бздурні купують бздурні, кожного разу. Радить забирати домени звідти, поки сервіс не просів ще більше.
-
Скорочення в SEO тепер ріжуть відділи цілком. У MarketWise звільнили всю SEO-команду через урізання бюджету, і її керівниця Alli Berry, авторка Search Engine Journal і Search Engine Land, публічно шукає роботу для чотирьох своїх людей і для себе.
-
Perplexity переписали з нуля систему, яка шукає сторінки в індексі і ранжує їх перед тим, як модель пише відповідь. Новий Photon написаний на Rust і замінив дороблене опенсорсне рішення, яке давало затримки до 800 мс на найповільніших запитах і тижневу синхронізацію нових серверів. Тепер 160 мс на пошуковий виклик у медіані, а швидкий пресет Search API на шести бенчмарках дав на 68% нижчу вартість зв'язки модель плюс пошук за ту саму якість. Писали Photon інженери разом з роєм кодинг-агентів.
Ще з цікавого
-
OpenAI бачать, які сайти ви відвідуєте, навіть якщо на банері згоди ви заборонили рекламне стеження. Розкопали Buchodi Threat Intel, Myriam Jessier рознесла знахідку. ChatGPT видає користувачу підписаний ідентифікатор, той лягає кукою __obi на рік, і конверсійні пікселі рекламодавців повертають його OpenAI разом з даними про відвідані сторінки, включно зі сторінками про хвороби і списання боргів. Meta Pixel на банерах згоди лежить у категорії маркетингу, тож відмова його блокує. OpenAI поклали свою куку в категорію аналітики, і відмова від маркетингу її не чіпає. Пошта й телефон хешуються, зате місто й поштовий індекс ідуть відкрито. Дослідники надіслали OpenAI запитання і відповіді не отримали.
-
OpenAI набирають робототехніків: 27 вакансій проти 11 у травні, базові вилки від $177 000 до $500 000 плюс акції. Найдорожча вакансія не про самих роботів: це інженер інфраструктури для обробки тренувальних даних. Є і окремий юрист під робототехніку, і менеджер власних центрів збору даних, бо роботам потрібні реальні приклади взаємодії з предметами, в інтернеті їх не назбираєш. Sam Altman каже, що гуманоїда вони зроблять точно, і першим застосуванням бачить обслуговування власних дата-центрів.
-
В OpenAI звільняють асесорів за те, що ті розмічають дані для AI за допомогою AI, пишуть 404 Media. Підрядники проєкту Project Lily читають реальні розмови користувачів з ChatGPT і оцінюють відповіді, інструкції забороняють їм LLM, Grammarly, GPTZero і AI-переклад. Ловлять порушників не детектором, а очима: за ем-тире, повторюваними формулюваннями і підозріло швидким виконанням, бо AI-детекторам OpenAI самі не довіряють. У внутрішніх документах згадано понад 10 000 підрядників на оцінювальних конвеєрах.
-
Dario Amodei заявив, що Claude знайшов молекулярну машину, яка може виявитись новим механізмом редагування генів: команда задала широку область, модель перечитала літературу й геномні дані, знайшла кандидата і запропонувала експерименти, люди їх провели. Сам Dario обережний: значущість поки неясна, і "як мінімум це робота, якою я пишався б як PhD-студент". Незалежного підтвердження поки немає, це заява компанії про власну модель.
-
Eli Schwartz нагадує про найпростіший прийом, який досі працює: звичайна HTML-карта сайту, згрупована за темами, з посиланням з головної або футера. На відміну від XML-карти її читають і краулери, і люди, і AI-системи. У SurveyMonkey за кілька днів після запуску такої карти краулери дійшли до найглибших шаблонних сторінок. Для сайту на кілька десятків сторінок сенсу мало, на десятках тисяч віддача величезна.