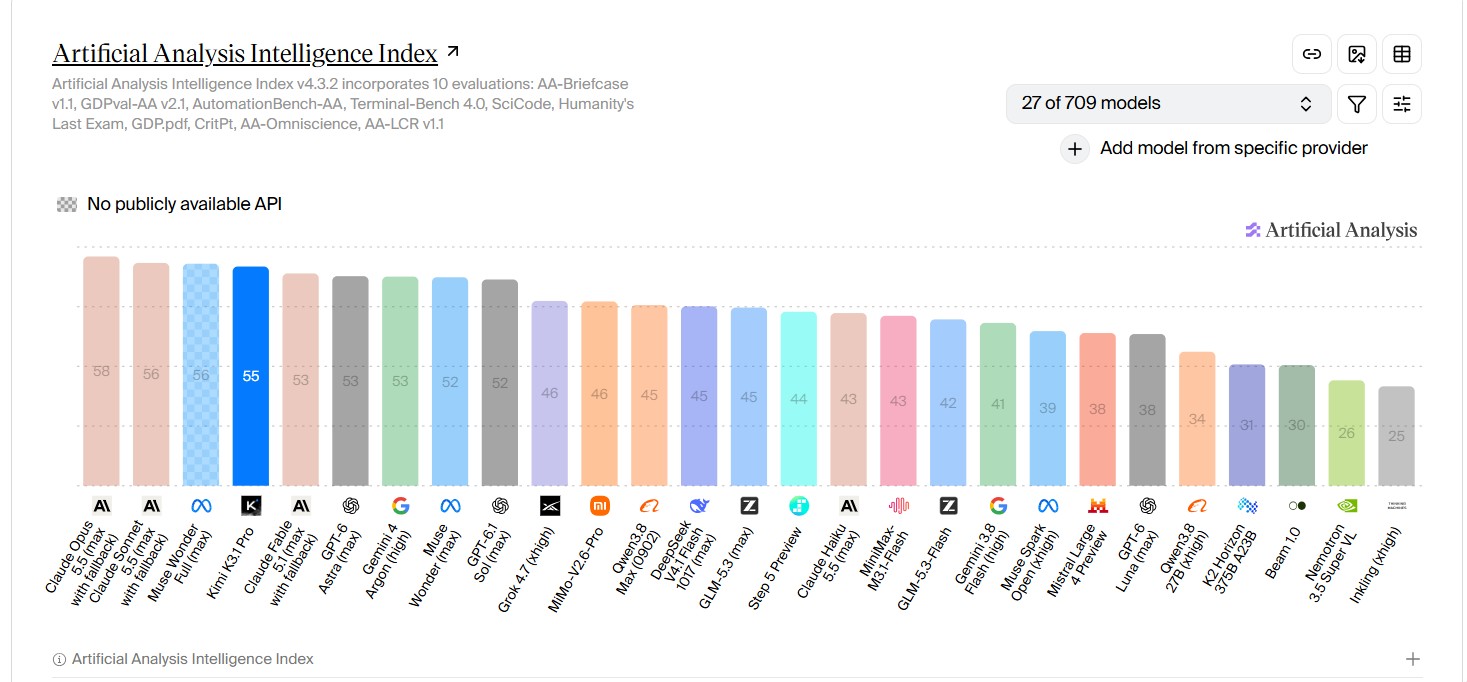
Kimi K3.1 Pro від Moonshot AI набрала 55 балів у незалежному індексі Artificial Analysis і обійшла Claude Fable 5.1 з її 53 балами. Цю новину ми згенерували трьома моделями на однакових фактах і однакових правилах стилю: Claude Fable 5.1, самою Kimi K3.1 Pro і її попередницею Kimi K3 з відкритими вагами. Тексти обох Kimi нижче без жодних правок. K3.1 Pro працює тільки на серверах Moonshot, її версія коштувала $0,24. K3 запускали через OpenRouter на серверах Together, незалежного хостингу, без участі Moonshot, за $0,26. У вересні ми так само порівнювали Qwen 3.8, Kimi K3 і Claude.
Версія Claude Fable 5.1
Kimi K3.1 Pro від китайської Moonshot AI набрала 55 балів у незалежному індексі Artificial Analysis і обійшла Claude Fable 5.1 з її 53 балами. Вище лише Claude Opus 5.5 з 58 і Claude Sonnet 5.5 з 56. Модель вийшла 23 жовтня, коштує через API $2 за мільйон вхідних токенів і $10 за мільйон вихідних, тобто в 5 разів дешевше за Fable 5.1 з її $10 і $50. Повні ваги Moonshot обіцяють відкрити до 4 листопада.
Що показує індекс
Artificial Analysis — це незалежна лабораторія, яка сама проганяє моделі через однакові тести і зводить результати в один бал. Версія індексу 4.3.2 складається з 10 тестів: ділові задачі, робота з документами, автоматизація, робота в терміналі, наукове програмування, Humanity's Last Exam, фінансові таблиці, фізика, фактологія і довгий контекст.
Kimi K3.1 Pro виграла в Claude Fable 5.1 у шести тестах із десяти:
- робота в терміналі Terminal-Bench 4.0: 67% проти 55%
- автоматизація AutomationBench: 73% проти 58%
- ділові задачі GDPval-AA: 1846 проти 1733 балів Elo
- задачі з документами AA-Briefcase: 1678 проти 1651 балів Elo
- фінансові звіти GDP.pdf: 31% проти 26%
- довгий контекст AA-LCR: 86% проти 83%
Fable 5.1 сильніша там, де потрібні знання і міркування: Humanity's Last Exam 59% проти 52%, фізичні задачі CritPt 31% проти 25%, фактологія AA-Omniscience 42 проти 30. У науковому програмуванні SciCode у обох по 61%.
Контекстне вікно в обох моделей по мільйону токенів. Швидкість видачі приблизно однакова: 73 токени за секунду в Kimi проти 65 у Fable.
Що кажуть самі Moonshot
В анонсі Moonshot пишуть, що K3.1 Pro — це та сама Kimi K3 з майже трьома трильйонами параметрів, але з набагато більшим обсягом донавчання. Модель доступна на kimi.ai, у мобільних застосунках, у Kimi Code і через API. Є варіант Highspeed, який за заявою компанії працює у два-три рази швидше і коштує вдвічі дорожче.
Власні цифри Moonshot, які ніхто ззовні не перевіряв:
- Terminal-Bench 4.0: 65,7% у K3.1 Pro, 66,4% у Claude Opus 5.5, 58,2% у GPT-6 Astra
- частка вигаданих тверджень на внутрішньому стрес-тесті впала з 23,4% у K3 до 8,3% у K3.1 Pro
- за цим же тестом із пошуком Claude Fable 5.1 показала 23,3%, Claude Opus 5.5 15%
Перед відкриттям ваг Moonshot прибрали з навчання дані про кібератаки. На їхньому внутрішньому тесті зі зломом реального софту модель без цих обмежень розв'язувала 90,5% задач, випущена версія 81%, попередня K3 33,3%.
Водяний знак у тексті K3.1 Pro
Kimi K3.1 Pro поки доступна тільки на серверах Moonshot. Водяний знак у тексті ставить сервер розробника, у самій моделі його немає, тому чи є він у відповідях K3.1 Pro, невідомо. Після відкриття ваг модель можна буде запускати на сторонньому хостингу, як ми робили з Kimi K3 і Qwen 3.8.
Версія Kimi K3.1 Pro
Kimi K3.1 Pro набрала 55 балів в незалежному Intelligence Index v4.3.2 від Artificial Analysis. Результат Claude Fable 5.1 у конфігурації xhigh становить 53 бали. Moonshot AI випустили нову модель 23 жовтня 2026 року.
Результати Artificial Analysis
Claude Opus 5.5 має 58 балів, Claude Sonnet 5.5 56, GPT-6 Astra і Gemini 4 Argon по 53, GPT-6.1 Sol 52.
Індекс складається з 10 тестів:
| Тест | Kimi K3.1 Pro | Claude Fable 5.1 |
|---|---|---|
| AA-Briefcase v1.1 | 1678 Elo | 1651 Elo |
| GDPval-AA v2.1 | 1846 Elo | 1733 Elo |
| AutomationBench-AA | 73% | 58% |
| Terminal-Bench 4.0 | 67% | 55% |
| SciCode | 61% | 61% |
| Humanity's Last Exam | 52% | 59% |
| GDP.pdf | 31% | 26% |
| CritPt | 25% | 31% |
| AA-Omniscience | 30 | 42 |
| AA-LCR v1.1 | 86% | 83% |
За даними Artificial Analysis про Kimi K3.1 Pro, модель коштує $2 за 1 млн вхідних токенів і $10 за 1 млн вихідних. Для Claude Fable 5.1 відповідні ціни становлять $10 і $50.
Швидкість Kimi K3.1 Pro становить 73 токени/с, Claude Fable 5.1 генерує 65 токенів/с. Контекстне вікно в обох моделей 1 млн токенів.
Анонс Moonshot AI
Kimi K3.1 Pro стала першою моделлю серії K3.1. Moonshot AI у своєму анонсі K3.1 Pro описують її як донавчену версію Kimi K3 зі значно більшим обсягом донавчання. У Kimi K3 майже 3 трлн параметрів.
Модель доступна на kimi.ai, у мобільних застосунках, Kimi Work, Kimi Code і через API з ідентифікатором kimi-k3.1-pro. Ваги моделі поки закриті. Moonshot AI обіцяють відкрити повні ваги до 4 листопада 2026 року.
Moonshot AI також пропонують варіант Highspeed, який, за їхніми даними, удвічі чи утричі швидший. Simon Willison у нотатці про запуск Kimi K3.1 Pro пише, що Highspeed коштує вдвічі дорожче.
Власні тести Moonshot AI
Moonshot AI опублікували власні бенчмарки. Їхні результати ззовні ніхто не перевіряв.
За даними Moonshot AI, у Terminal-Bench 4.0 K3.1 Pro набрала 65,7%, Claude Opus 5.5 66,4%, GPT-6 Astra 58,2%.
У внутрішньому тесті на вигадані факти Kimi Hallu Bench Hard частка вигаданих тверджень знизилась з 23,4% у K3 до 8,3% у K3.1 Pro. У тесті з інструментами цей показник становив 5,5% у GPT-6 Astra, 8,3% у K3.1 Pro, 15,0% у Claude Opus 5.5 і 23,3% у Claude Fable 5.1.
Перед відкриттям ваг Moonshot AI прибрали з навчання дані про кібератаки. У внутрішньому тесті xdev-bench-hard результат версії без обмежень становив 90,5%, випущеної K3.1 Pro 81,0%, попередньої K3 33,3%.
SEO Baza раніше генерувала одну новину трьома моделями. Kimi K3 для того матеріалу запускали на сторонньому хостингу Together через OpenRouter. Окремо ми розбирали, як побачити і прибрати водяний знак у тексті. Водяний знак ставить сервер розробника, модель цього не робить.
Версія Kimi K3
Moonshot AI з Китаю 23 жовтня 2026 року випустили модель Kimi K3.1 Pro, першу в новій серії K3.1. У незалежному індексі Artificial Analysis Intelligence Index v4.3.2 вона набрала 55 балів і обійшла Claude Fable 5.1 від Anthropic, у якої 53. Вище за Kimi K3.1 Pro в індексі тепер тільки Claude Opus 5.5 з 58 балами і Claude Sonnet 5.5 з 56. Стільки ж, 53 бали, мають GPT-6 Astra і Gemini 4 Argon. GPT-6.1 Sol набирає 52.
Покомпонентні результати в індексі
Індекс складається з 10 тестів: AA-Briefcase v1.1, GDPval-AA v2.1, AutomationBench-AA, Terminal-Bench 4.0, SciCode, Humanity's Last Exam, GDP.pdf, CritPt, AA-Omniscience і AA-LCR v1.1.
У покомпонентному порівнянні Kimi K3.1 Pro і Claude Fable 5.1 Fable взята в стандартній конфігурації xhigh. Першим у кожній парі йде результат Kimi K3.1 Pro, другим Claude Fable 5.1:
- AA-Briefcase v1.1: 1678 проти 1651 Elo.
- GDPval-AA v2.1: 1846 проти 1733 Elo.
- AutomationBench-AA: 73% проти 58%.
- Terminal-Bench 4.0: 67% проти 55%.
- SciCode: по 61% в обох.
- Humanity's Last Exam: 52% проти 59% на користь Fable.
- GDP.pdf: 31% проти 26%.
- CritPt: 25% проти 31% на користь Fable.
- AA-Omniscience: 30 проти 42 на користь Fable.
- AA-LCR v1.1: 86% проти 83%.
Ціна і швидкість
- API Kimi K3.1 Pro коштує $2 за мільйон вхідних токенів і $10 за мільйон вихідних. Claude Fable 5.1 коштує $10 і $50 відповідно.
- Швидкість генерації: 73 токени за секунду в Kimi K3.1 Pro проти 65 у Fable 5.1.
- Контекстне вікно в обох моделей 1 мільйон токенів.
Що повідомили Moonshot
Kimi K3.1 Pro донавчена з Kimi K3, моделі з майже 3 трильйонами параметрів, зі значно більшим обсягом донавчання. Модель доступна на kimi.ai, у мобільних застосунках, Kimi Work, Kimi Code і через API під ім'ям kimi-k3.1-pro. Ваги наразі закриті. Повні ваги Moonshot обіцяють відкрити до 4 листопада 2026 року.
Окремий варіант Highspeed працює у 2-3 рази швидше за основний. Simon Willison у своєму дописі про Kimi K3.1 Pro зазначає, що Highspeed коштує вдвічі дорожче.
Власні вимірювання Moonshot, які ніхто ззовні не перевіряв:
- Terminal-Bench 4.0: Kimi K3.1 Pro 65,7%, Claude Opus 5.5 66,4%, GPT-6 Astra 58,2%.
- Внутрішній тест на вигадані факти Kimi Hallu Bench Hard: частка вигаданих тверджень впала з 23,4% у Kimi K3 до 8,3% у K3.1 Pro. У версії тесту з інструментами результати такі: GPT-6 Astra 5,5, Kimi K3.1 Pro 8,3, Claude Opus 5.5 15,0, Claude Fable 5.1 23,3.
Перед відкриттям ваг Moonshot прибрали з навчання дані про кібератаки, детально про це пише The Next Web. У внутрішньому тесті xdev-bench-hard версія без обмежень набирає 90,5%, випущена Kimi K3.1 Pro 81,0%, попередня Kimi K3 33,3%.
У вересні ми самі генерували одну й ту саму новину трьома моделями. Kimi K3 тоді запускали на сторонньому хостингу Together через OpenRouter.